Veelgemaakte fouten in softwareontwikkeling vermijden (met echte case)
Softwareontwikkeling is boeiend, maar het is ook een serieuze investering, met veel mensen die elk hun eigen rol spelen. Zelfs ervaren teams trappen in dezelfde valkuilen, en die zorgen voor vertraging, budgetoverschrijdingen en in het slechtste geval een product dat niemand nog vertrouwt.
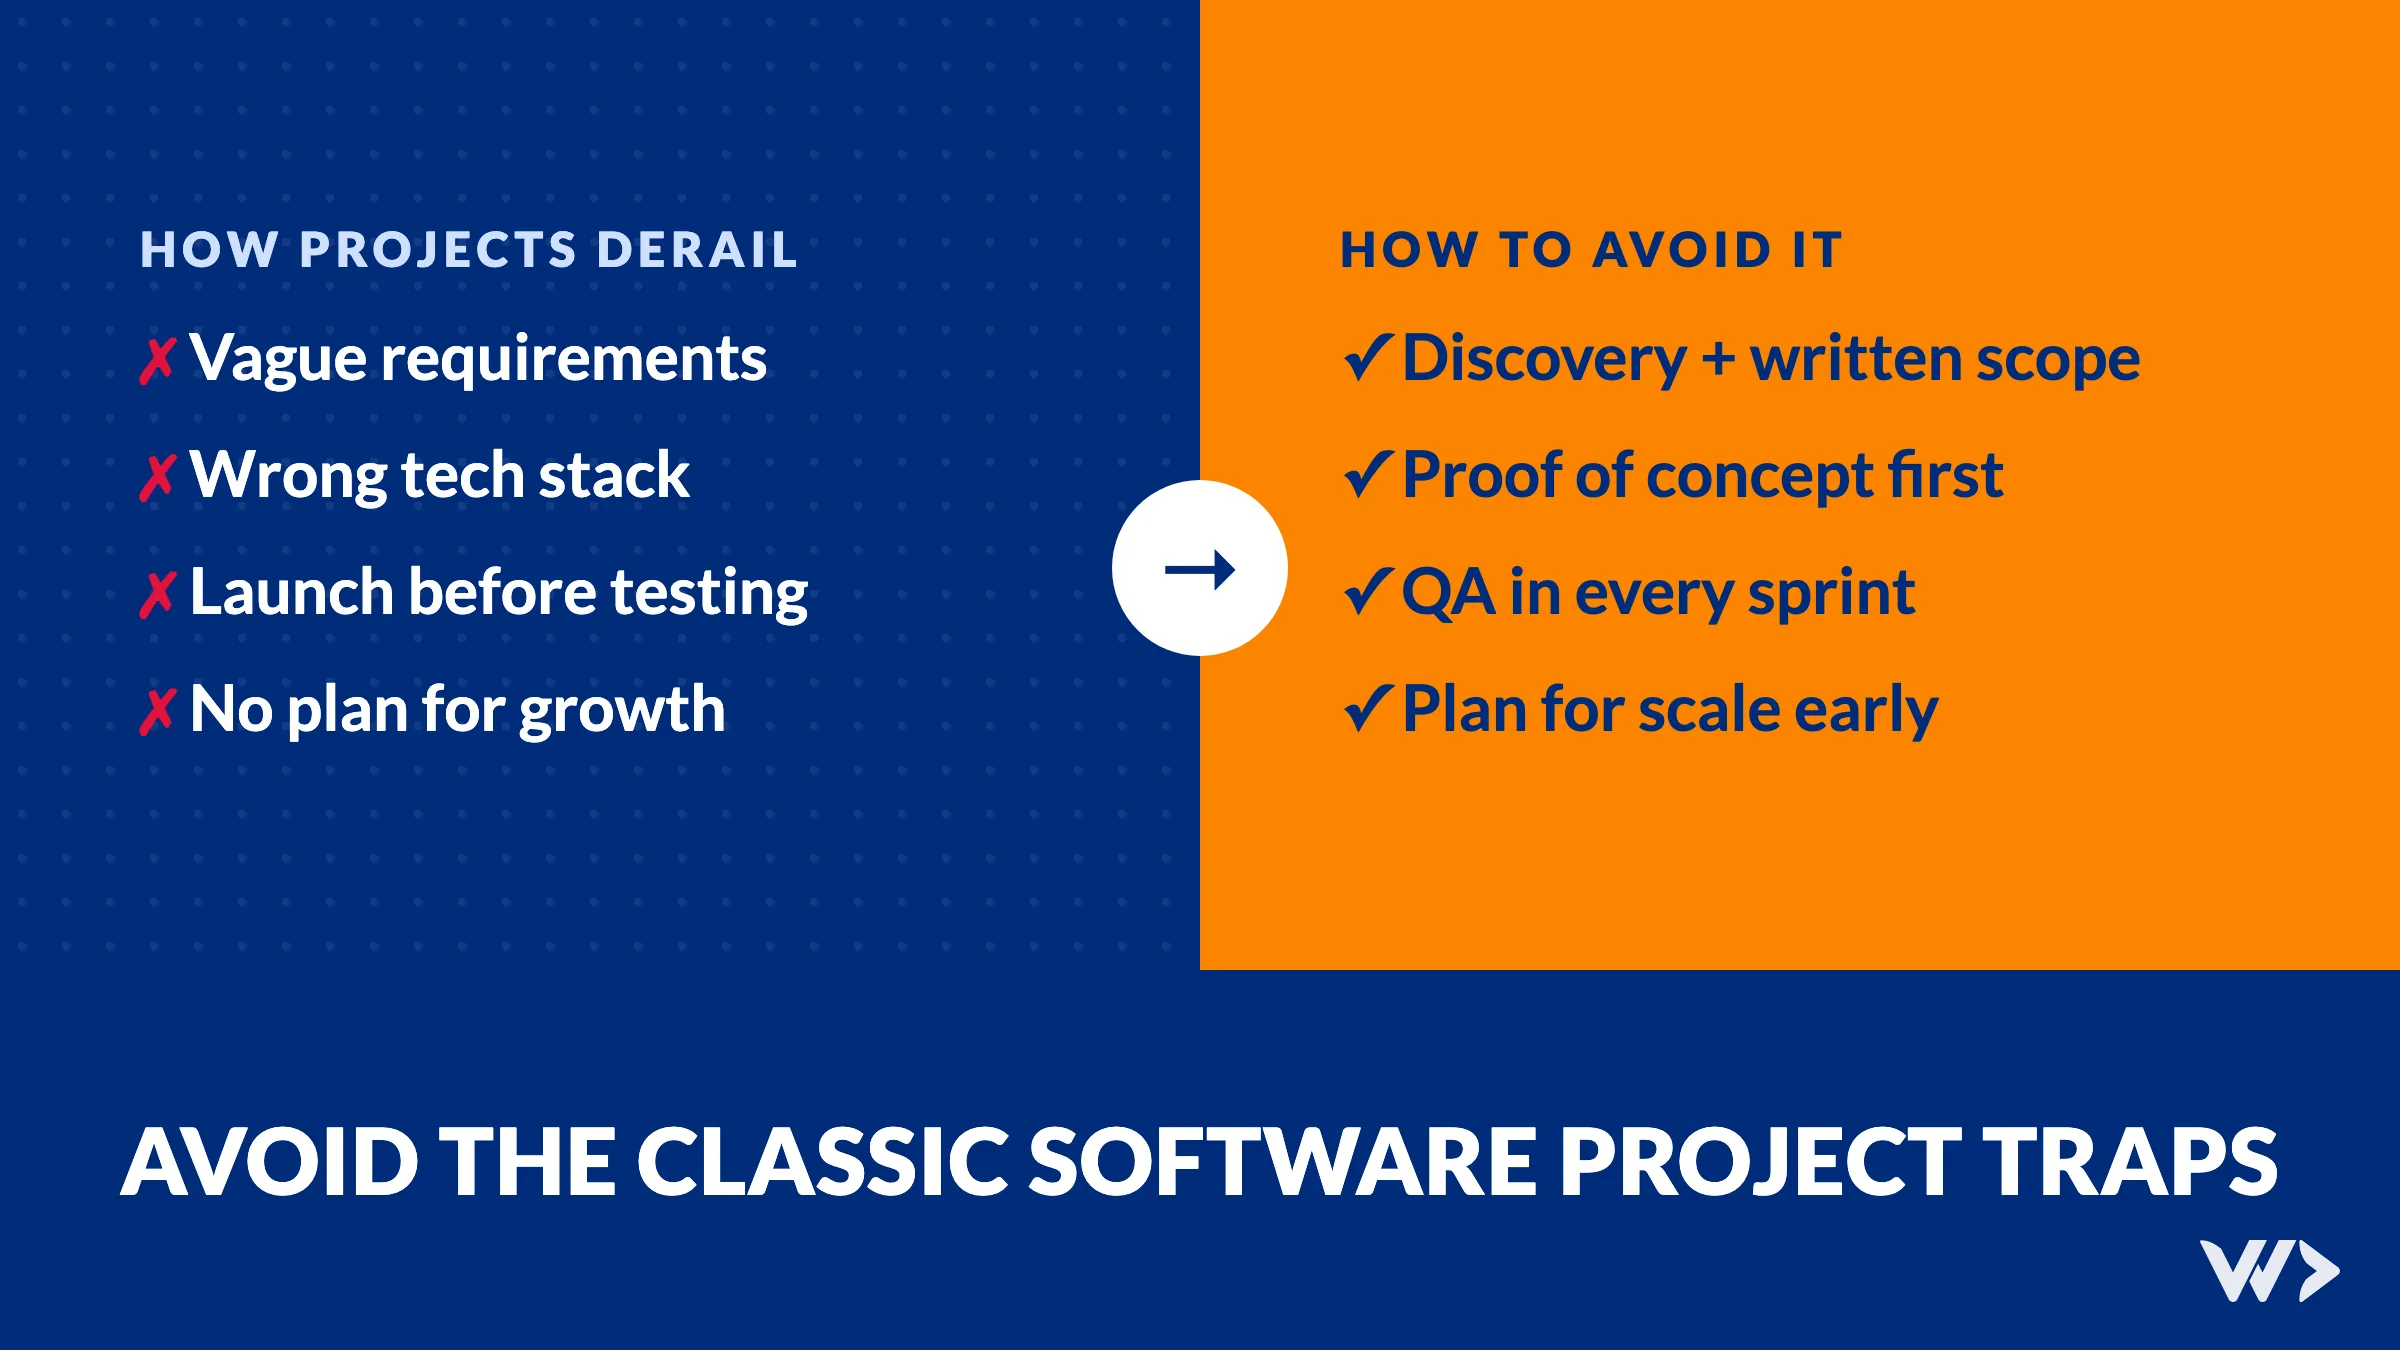
Het korte antwoord: de meeste projecten die mislopen, struikelen over vier dingen. Een zwakke basis, de verkeerde tech stack, lanceren vóór het testen, en negeren wat er gebeurt als het product succes heeft. Hieronder lopen we ze een voor een door, tonen we een echte case uit ons eigen werk en sluiten we af met een checklist die je kunt gebruiken voordat je volgende project start. Of je nu ondernemer, projectleider of engineer bent: jouw keuzes doen ertoe.
De vier valkuilen in één oogopslag
| Valkuil | Wat je merkt | Hoe je het vermijdt |
|---|---|---|
| Zwakke basis | Scope creep, eindeloos herwerk, gemiste deadlines | Discoveryfase, uitgeschreven scope, geprioriteerde backlog |
| Verkeerde tech stack | Trage voortgang, rare bugs, dure herschrijvingen | Een stack die het team kent, eerst een proof of concept |
| Lanceren vóór het testen | Kritieke bugs direct na livegang, gebruikers verliezen vertrouwen | QA in elke sprint, acceptatietests met gebruikers, gefaseerde releases |
| Schaalbaarheid negeren | Trage app, stijgende cloudfacturen, beveiligingsrisico's naarmate je groeit | Vroeg plannen voor groei, goede engineeringpraktijken volgen |

1. Een zwakke projectbasis
In de kern van elk project zit een idee: een functie die een probleem oplost waarvan sommige mensen nog niet eens weten dat ze het hebben. Als we de basis leggen, verzamelen we de requirements en vertalen we die naar een korte lijst functies die dat kernidee ondersteunen.
Als die requirements verkeerd begrepen worden, krijg je scope creep en herwerk. Wat een paar weken eenvoudig werk leek, wordt een slagveld van moeilijke beslissingen. De kwaliteit daalt om deadlines te halen, technische schuld stapelt zich op, teamleden raken gedemotiveerd en gebruikers krijgen een traag product vol bugs.
Hoe je het vermijdt: doe grondig onderzoek in een discoveryfase, toets ontwerpen en plannen bij de stakeholders, schrijf de scope op één pagina en leg beslissingen vast, zodat er later minder discussie is.
- Als stakeholder: blijf betrokken, beslis wat je eerst nodig hebt, vraag om regelmatige updates en geef snel feedback.
- Als projectleider: stel duidelijke grenzen en realistische deadlines, hou je eraan en bewaar het vertrouwen van de klant met open communicatie.

2. De verkeerde tech stack kiezen
Zodra er een plan is, beslist een softwarearchitect welke talen, frameworks, externe API's, testtools en hosting er gebruikt worden. De stack mag niet te zwaar en niet te licht zijn: flexibel genoeg voor de veranderingen die zeker komen, met genoeg ingebouwd om op tijd te leveren.
Drie fouten zien we keer op keer:
- Een gesloten tool. Met sommige platformen bouw je snel zonder veel code, tot de eerste requirement die het platform niet ondersteunt. Vanaf dan wordt elke wijziging een omweg.
- Een stack die het team niet kent. Voor elke functie eerst uitzoeken hoe het moet, vertraagt alles, en door gebrek aan ervaring glippen bugs door de code review.
- Slechte ondersteuning. Een framework met weinig updates, magere documentatie of weinig beschikbare ontwikkelaars wordt moeilijk en duur om te onderhouden.
Hoe je het vermijdt: weeg vendor lock-in, leercurve, beveiliging en onderhoud op lange termijn af, en vraag je af hoe het product omgaat met veel meer gebruikers. Bouw een kleine proof of concept voordat je je vastlegt op een lang traject.
- Als stakeholder: leg je team geen stack op. Beslis samen, of kies een team dat al ervaring heeft met de technologie die je wilt.
- Als projectleider: leg de architectuur uit aan alle stakeholders en bemand het project met mensen die met vertrouwen in die stack kunnen leveren.
3. Lanceren vóór het testen
Onder druk van een deadline verklaren teams zich soms klaar om live te gaan, om na de lancering kritieke problemen te ontdekken. Die problemen krijgen dan plots topprioriteit, kosten meer om op te lossen en geven gebruikers een slechte eerste indruk.
De ergste bugs zijn niet de bugs waardoor de app crasht. Het zijn de bugs die ongemerkt foute data tonen. Mensen verliezen hun vertrouwen in het systeem, grijpen terug naar hun eigen spreadsheets, en de investering verliest langzaam haar waarde.
Hoe je het vermijdt: maak testen deel van elke sprint, niet een fase aan het einde. Test in meer dan één omgeving, doe acceptatietests met echte gebruikers en release in fases. Automatiseer de tests voor modules die vaak veranderen of waar het bedrijf op draait.
- Als stakeholder: vraag om kwaliteit boven kwantiteit, wees realistisch over deadlines, doe mee aan de acceptatietests en vraag om testrapporten.
- Als projectleider: bouw buffers in de planning, spreek met iedereen af wat "klaar" betekent en organiseer reviewmomenten waarin het team werkende software toont.
Een echte case: één functie ruim een jaar stuk
Waterleau, een Belgisch waterzuiveringsbedrijf, bouwde een interne Capacity Planning Tool om projectleiders en het senior management een helder zicht te geven op resources, budgetten en de winstgevendheid van projecten. Een van de meest kritieke functies, de "freeze hours"-functie met SAP-koppeling, werkte al meer dan een jaar niet goed. De vorige ontwikkelpartner kreeg het niet opgelost.
Het gevolg was precies waar dit artikel voor waarschuwt. De data was niet meer betrouwbaar, planners grepen terug naar hun eigen Excel-bestanden, en een flinke investering dreigde een tool te worden die niemand gebruikte.
We stapten in een codebase die geschreven was door verschillende engineers met elk hun eigen standaarden en weinig documentatie. In plaats van nog een snelle fix toe te passen, brachten we eerst in kaart hoe het systeem zich echt gedroeg. Daarna bouwden we de freeze-hours-module opnieuw, refactorden we de betrokken code en voegden we datacontroles toe die elk verschil tussen SAP en wat de tool toont meteen signaleren. De volledige oplossing werd binnen acht weken opgeleverd, op tijd. Vandaag werken we met Waterleau aan de volgende fase van het platform.
De les: bijna elke valkuil hierboven was zichtbaar in één project. Onduidelijk eigenaarschap van de code, geen tests rond een kritieke koppeling, en fixes die symptomen behandelden in plaats van de oorzaak. Lees het volledige verhaal in onze Waterleau-case.

4. Schaalbaarheid negeren
Het product is live, proficiat. Dan groeit het aantal gebruikers. Sommige services houden het bij, andere beginnen te sputteren, gebruikers merken de traagheid en de eerste negatieve reviews komen binnen. Succes wordt een last.
Je voorbereiden op succes is net zo belangrijk als risico's beperken. Cloudkosten stijgen als het enige antwoord meer servers is. Beveiliging weegt zwaarder naarmate meer mensen je hun data toevertrouwen. En nieuwe functies toevoegen wordt moeilijker in een overhaaste, rommelige codebase.
Hoe je het vermijdt: denk vanaf het begin na over groei. Volg goede praktijken bij het schrijven van code, het opzetten van servers en het opslaan van data, en kies een architectuur die met het product kan meegroeien zonder de eerste versie te zwaar te maken.
- Als stakeholder: deel je ambitie. Hoe ziet het beste scenario eruit, en welke droomfuncties zijn niet nodig voor de eerste versie?
- Als projectleider: zorg dat de codeerrichtlijnen gevolgd worden, voer interne audits uit en houd het team gefocust op de lange termijn.
Checklist voordat je volgende project start
- Staat de scope op één pagina, en hebben de mensen die de software gaan gebruiken die bevestigd?
- Is er aan klantzijde één persoon die de productbeslissingen neemt?
- Heeft het team echte ervaring met de gekozen stack, of is er een proof of concept?
- Wie is vanaf dag één eigenaar van de code, de hosting en de accounts?
- Is testen gepland in elke sprint, met een duidelijke definitie van "klaar"?
- Weet je wat er gebeurt als het aantal gebruikers vertienvoudigt?
- Is er een plan en een budget voor onderhoud na de lancering?
Conclusie
Elke stap in de ontwikkelcyclus telt. Wie de processen overslaat die onbelangrijk lijken, bouwt technische schuld op die duur is om weg te werken, of die in het slechtste geval het project doet zinken. Ook bij We Do Dev Work maken we fouten. Elk team houdt sprintretrospectives om ze bespreekbaar te maken en onze manier van werken te verbeteren. We houden klanten betrokken en op de hoogte, en we kiezen voor onderhoudbare software en lange samenwerkingen boven kunstmatige deadlines.
Is je project al ontspoord? Lees hoe we softwareprojecten redden, of vertel ons wat er aan de hand is. Een gratis EngineeringScore-audit geeft je snel een eerste beeld van de gezondheid van een live site.
Verder lezen
Veelgestelde vragen
Wat zijn de meest voorkomende valkuilen in softwareontwikkeling?
Vier komen terug in bijna elk project dat misloopt: een slechte basis (onduidelijke requirements), de verkeerde tech stack, lanceren zonder goed te testen en schaalbaarheid negeren.
Hoe vermijd je scope creep en herwerk?
Begin met een discoveryfase: onderzoek het probleem, schrijf de scope op één pagina, valideer de ontwerpen met de mensen die de software gaan gebruiken en houd een geprioriteerde backlog bij. Elke nieuwe vraag wordt dan een bewuste afweging in plaats van stil extra werk.
Hoe kies je de juiste tech stack?
Kijk naar vendor lock-in, de leercurve voor je team, beveiliging, ondersteuning vanuit de community en onderhoudbaarheid op lange termijn. Bouw daarna een kleine proof of concept voordat je je vastlegt op een lang ontwikkeltraject.
Waarom is testen vóór de lancering zo belangrijk?
Bugs die je na de lancering vindt, worden meteen urgent en kosten meer om op te lossen. Een functie die ongemerkt foute data toont, ondermijnt het vertrouwen in het hele systeem. Test in meerdere omgevingen, doe acceptatietests met gebruikers en maak QA deel van elke sprint.
Wat kun je doen als een project al is misgelopen?
Stop met nieuwe functies toevoegen, laat een onafhankelijk team in kaart brengen hoe het systeem echt werkt en pak de oorzaak aan in plaats van symptomen te lappen. Bij Waterleau hebben we een kapotte module met SAP-koppeling opnieuw gebouwd en de volledige oplossing binnen acht weken opgeleverd.
Gerelateerde artikelen
Supabase vs Firebase (2026): welke kies je voor je app?
Supabase of Firebase in 2026? Een vergelijking van een team met drie producten op Supabase: datamodel, beveiliging, prijzen van 19 nov 2026 en hoe je kiest.

Claude Fable 5.2 getest op twee echte bugs: de moeite waard?
Claude Fable 5.2 kwam uit op 9 nov 2026. We gaven het en Opus 5.5 twee echte bugs van onze eigen site: beide vonden de oorzaak, Opus voor minder dan de helft.
WordPress-onderhoud voor bureaus: white-label, 50+ sites
Hoe een designbureau WordPress-onderhoud voor 50+ klantsites verkoopt zonder eigen developer: het werk, de kosten en wat er gebeurt op patchdag.