Claude Fable 5.2 testé sur 2 vrais bugs : vaut-il le prix ?
Réponse courte : Claude Fable 5.2, publié par Anthropic le 9 novembre 2026, est le modèle Claude le plus puissant disponible aujourd'hui pour le travail technique difficile, et il coûte 20 % de moins que Fable 5.1. Par token, il coûte toujours deux fois plus cher que Claude Opus 5.5. Le 11 novembre, nous avons soumis aux deux modèles deux vrais bugs de notre propre site, wedodevwork.com. Les deux ont trouvé la cause racine des deux bugs. Opus 5.5 l'a fait pour moins de la moitié du prix. Pour le développement de tous les jours, Opus 5.5 est le meilleur achat ; gardez Fable 5.2 pour les problèmes où Opus bloque. Anthropic donne le même conseil.
Ce qui est nouveau dans Claude Fable 5.2
Fable 5.2 et Mythos 5.2 sont sortis le lundi 9 novembre 2026. Mythos 5.2 est le même modèle de base, avec des garde-fous moins stricts en cybersécurité et en biologie, réservé aux organisations vérifiées. Fable 5.2 est ouvert à tous sur un abonnement payant et via l'API. Ce qui compte si vous payez :
Prix : $8 par million de tokens en entrée et $40 par million en sortie, contre $10 et $50 pour Fable 5.1. Opus 5.5 coûte $4 et $20.
Vitesse : selon Anthropic, les réponses arrivent jusqu'à 30 % plus vite qu'avec Fable 5.1. Un mode rapide, jusqu'à 2,5 fois plus rapide, coûte $16 et $80 par million de tokens.
Où : les applications Claude avec les formules Pro (payant avec des crédits d'utilisation), Max, Ultra, Team et Enterprise, l'API Claude sous le nom
claude-fable-5-2, Amazon Web Services, Google Cloud, Microsoft Foundry et Claude Code.Garde-fous : les questions de cybersécurité et de biologie signalées par les garde-fous reçoivent la réponse d'un modèle moins performant. Si votre travail légitime en sécurité est touché, Anthropic propose un Cyber Verification Program.
Données : par défaut, Anthropic conserve les données 30 jours pour la surveillance de la sécurité. Les clients éligibles peuvent l'utiliser sans aucune conservation des données.
Sur les benchmarks d'Anthropic, Fable 5.2 obtient 69,9 % sur FrontierSWE v2 (codage agentique), contre 56,3 % pour Fable 5.1 et 62,3 % pour Opus 5.5. Sur AutomationBench, un test de workflows d'entreprise, il obtient 51,4 % contre 42,5 % pour Opus 5.5. Ce sont les chiffres du fournisseur. Nous voulions voir ce qu'il fait avec notre propre code.
Notre test : deux bugs corrigés sur notre propre site
Nous avons choisi deux bugs déjà corrigés dans le code de wedodevwork.com, donc nous connaissions la bonne réponse. Pour chaque bug, nous avons exporté le code tel qu'il était juste avant notre correction, sans l'historique git, de sorte que la correction et notre message de commit n'étaient pas à trouver. Chaque modèle a reçu le même court rapport de bug, la même copie du code et un accès en lecture seule : il pouvait lire et chercher dans les fichiers, sans rien exécuter ni modifier. Nous avons lancé les deux dans Claude Code le 11 novembre 2026, une exécution par modèle et par bug.
Bug 1, du 4 novembre : nos articles de blog ne listaient que leur propre langue dans les balises hreflang, celles qui indiquent à Google quelle page est la version néerlandaise, française ou thaï. La page semblait parfaite ; seul le code source HTML le montrait. Nous avons décrit la cause dans 5 erreurs de SEO multilingue trouvées sur notre propre site.
Bug 2, du 1er novembre : après une courte fenêtre de maintenance de la base de données, chaque URL thaï, néerlandaise, française et allemande redirigeait vers une adresse anglaise cassée, alors que la base fonctionnait de nouveau. Une vraie panne sur notre site en production.
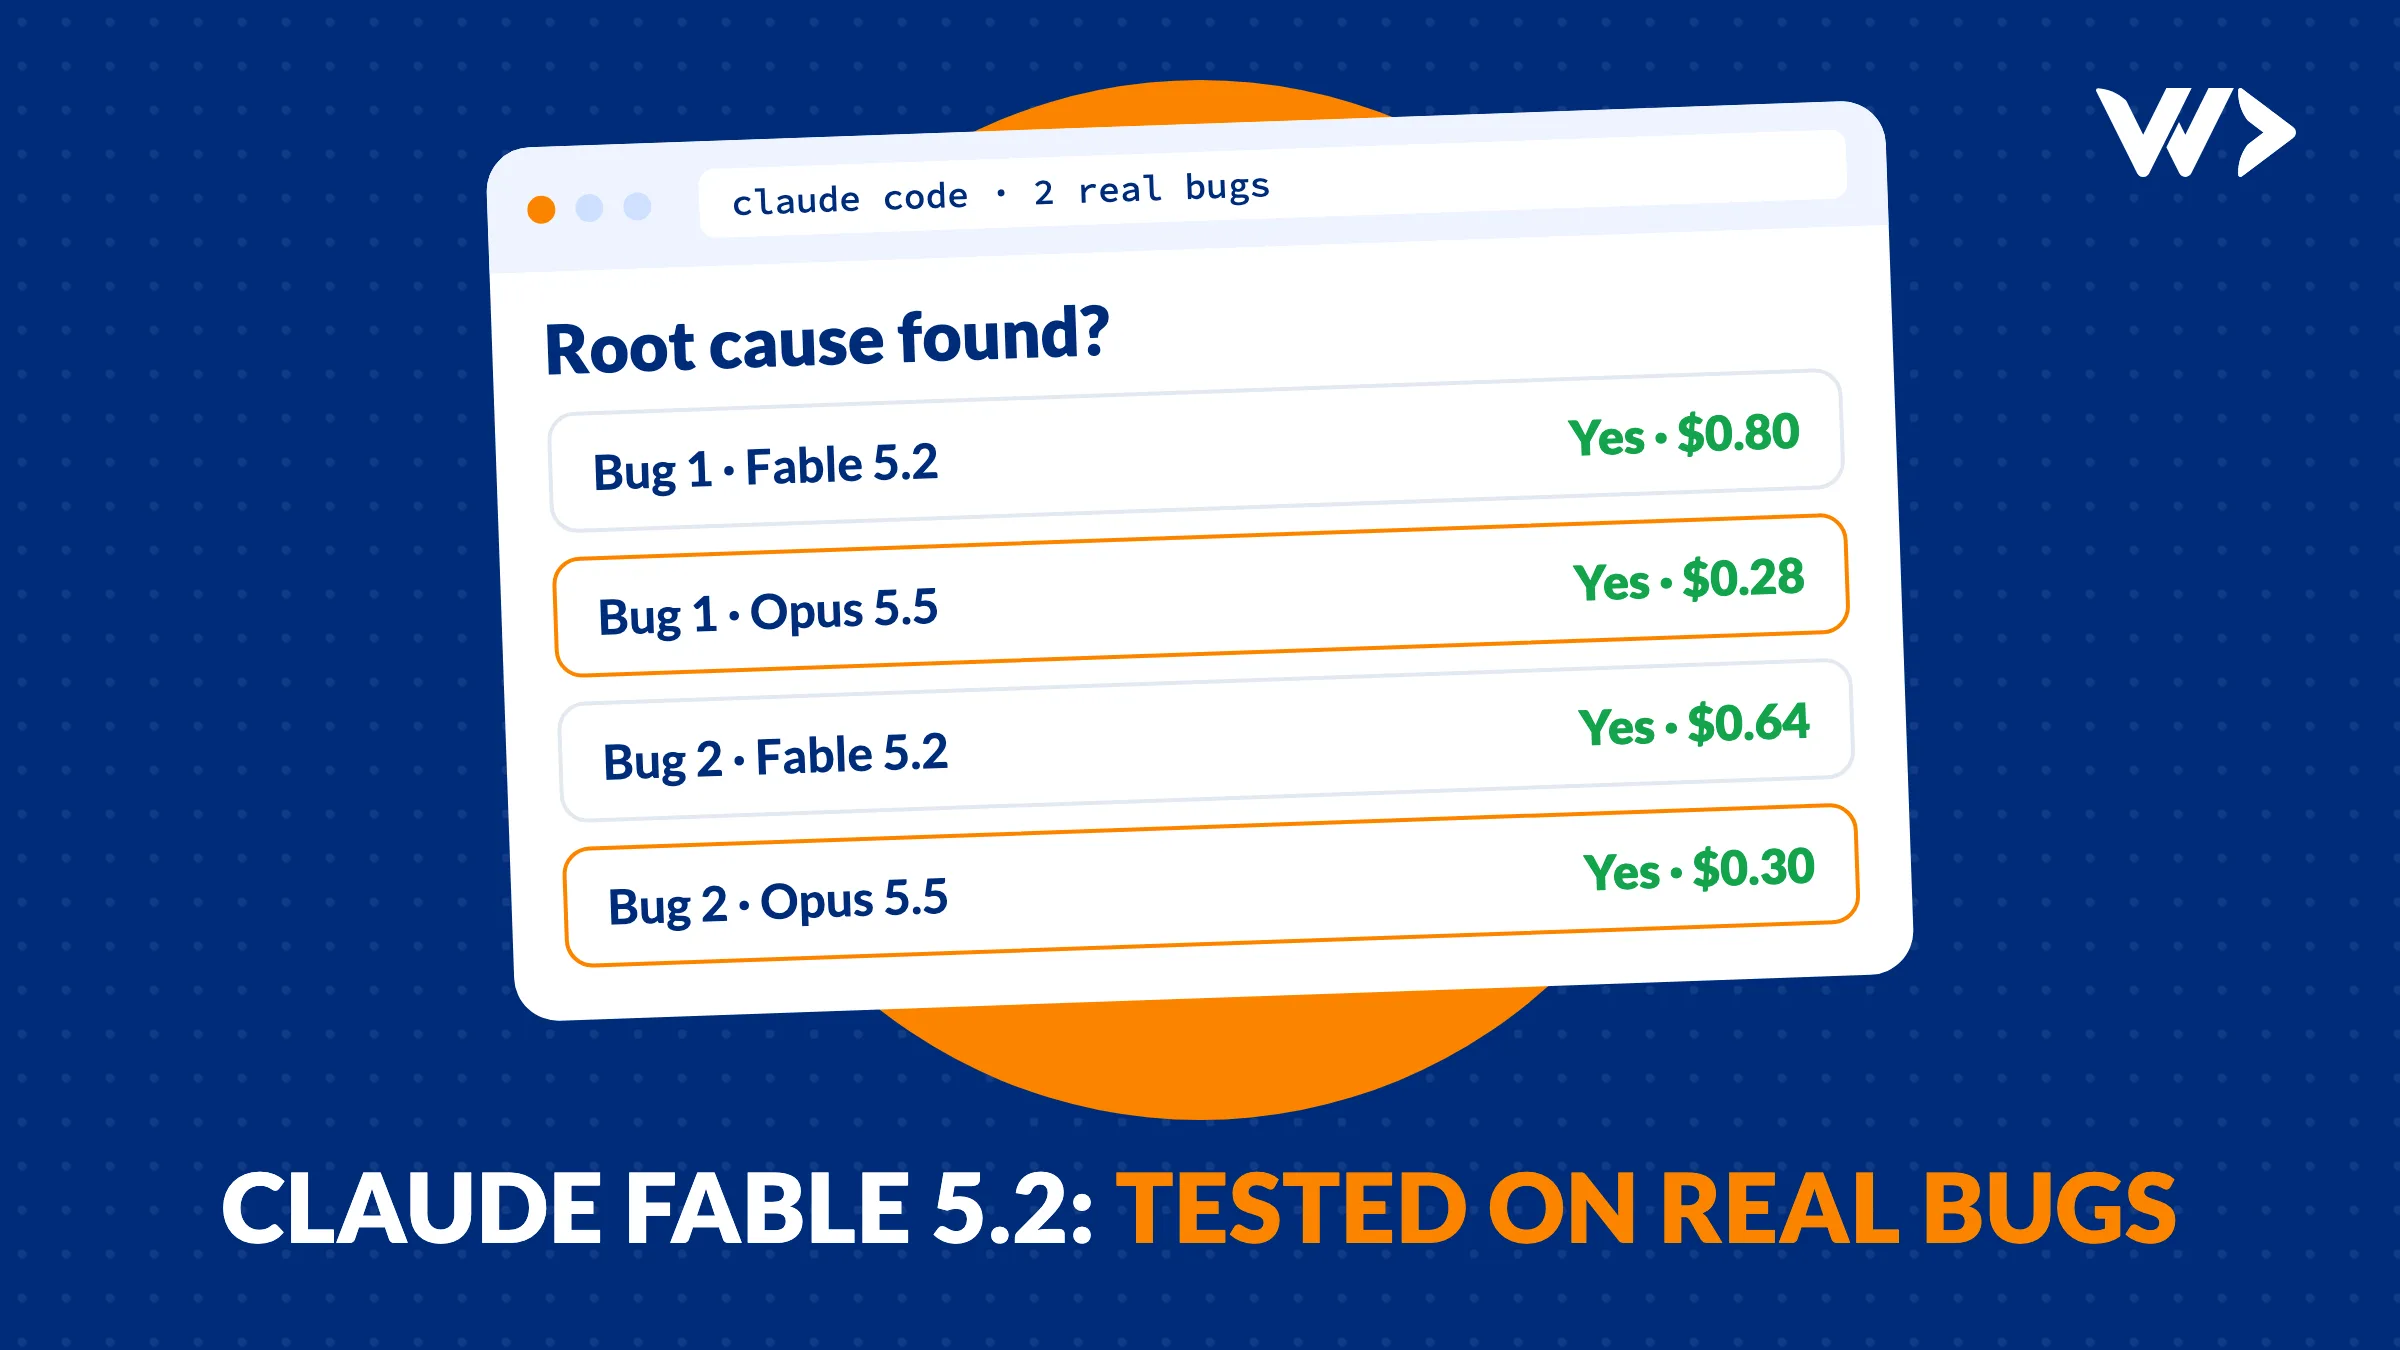
| Bug | Modèle | Cause racine trouvée | Durée | Coût |
|---|---|---|---|---|
| 1 : hreflang sur les articles de blog | Fable 5.2 | Oui | 30 secondes | $0,80 |
| 1 : hreflang sur les articles de blog | Opus 5.5 | Oui | 24 secondes | $0,28 |
| 2 : URL de langue cassées après la maintenance | Fable 5.2 | Oui | 35 secondes | $0,64 |
| 2 : URL de langue cassées après la maintenance | Opus 5.5 | Oui | 44 secondes | $0,30 |
Le coût est celui que Claude Code a indiqué pour chaque exécution, aux tarifs de l'API. Les deux modèles ensemble nous ont coûté $2,02 pour quatre exécutions.
À quoi ressemblaient les réponses
Bug 1. Les deux modèles ont désigné le même fichier et la même ligne que nous avions corrigés : la page de blog renvoyait la liste de ses traductions sous le nom languages, ce qui remplaçait la liste globale du site que lit notre composant SEO. Les deux ont proposé de renommer cette seule clé, ce qui est exactement ce que nous avons fait. Chacun a aussi repéré un effet de bord que nous n'avions pas noté : Fable 5.2 a remarqué que le sélecteur de langue lisait la même liste cassée sur les pages de blog, et Opus 5.5 a remarqué que la recherche de la devise le faisait aussi.
Bug 2. Les deux ont trouvé la ligne où le site mettait en cache sa liste de langues. Quand la requête vers la base a échoué pendant la maintenance, le code est revenu à « anglais uniquement » et a gardé cette réponse en mémoire jusqu'au redémarrage du serveur. Les deux ont expliqué pourquoi elle a survécu au retour de la base, et les deux ont donné la même façon de rétablir la situation tout de suite : redéployer, puis vider le cache du CDN.
Puis une surprise : les deux ont proposé une meilleure correction que celle que nous avions livrée. Notre correction du 1er novembre arrêtait de mettre en cache la mauvaise réponse, mais pendant une panne elle revient quand même à l'anglais uniquement, donc les visiteurs sont toujours mal aiguillés tant que la base est en panne. Les deux modèles ont suggéré une liste fixe de nos cinq langues comme solution de repli, pour que personne ne soit mal redirigé. Opus 5.5 est allé un cran plus loin en signalant que notre redirection de langue est une 301 permanente, que les navigateurs conservent, et qu'elle ne devrait pas être mise en cache.
Deux bugs et une exécution chacun, ce n'est pas un benchmark. Les deux bugs étaient du genre qu'un développeur expérimenté trouve en une heure : un fichier, un symptôme clair. C'est justement le but. La plupart des bugs dans les logiciels d'une entreprise ressemblent à cela, et sur ce type de travail, le modèle le moins cher était tout aussi bon.
Quel modèle Claude pour quel travail
| Travail | Modèle que nous choisirions | Prix par million de tokens (entrée / sortie) |
|---|---|---|
| Bugs, fonctionnalités, revue de code, développement de tous les jours | Opus 5.5 | $4 / $20 |
| Travail technique long et ambigu, recherche, problèmes où Opus bloque | Fable 5.2 | $8 / $40 |
| La même tâche de nombreuses fois par jour : tri, extraction, réponses courtes dans votre propre produit | Sonnet 5.5 ou Haiku 5.5 | $2 / $10 et $0,10 / $0,50 |
Anthropic recommande elle-même Opus 5.5 pour la plupart des tâches de codage et de travail sur la connaissance, et présente Fable 5.2 comme le modèle des problèmes difficiles en ingénierie, en mathématiques et en sciences. Notre test lui donne raison pour la partie quotidienne. Là où Fable 5.2 mérite son prix, c'est dans le travail que nous n'avons pas testé : les longues missions à nombreuses étapes, où un meilleur modèle prend moins de fausses pistes.
Ce que cela change si vous développez des logiciels avec l'IA
Le coût du modèle est rarement la partie chère. Quatre exécutions ont coûté $2,02 ; un développeur senior qui lit la réponse, la vérifie dans le code et teste la correction coûte bien plus, et cette étape n'est pas facultative. Les deux modèles ont dit, à juste titre, qu'ils avaient travaillé à partir du code seul et n'avaient rien exécuté. Un modèle qui semble sûr de lui n'est pas la même chose qu'une correction qui fonctionne.
C'est ainsi que nous utilisons Claude nous-mêmes. Nos propres sessions Claude prennent des tickets sur le tableau de notre équipe et y font leur rapport, et un développeur relit chaque modification avant sa mise en ligne. Pour savoir comment connecter votre propre logiciel à Claude, lisez connecter votre logiciel à Claude ou ChatGPT. Si un outil d'IA a construit votre produit et que vous n'êtes pas sûr qu'il soit prêt pour de vrais clients, lisez mon produit vibe-codé est-il prêt. Et si vous hésitez entre un outil sur mesure et un abonnement, développer ou acheter un logiciel montre comment l'IA a changé ce calcul.
Envie que nous regardions votre code ?
Nos développeurs seniors travaillent chaque jour avec ces modèles et relisent ce qu'ils produisent. Un bug comme les deux ci-dessus demande généralement quelques heures pour être trouvé, corrigé et testé, que vous pouvez payer à l'heure ou avec une carte d'heures de 14 heures pour 910 €. Pour un projet plus important, découvrez nos projets, ou contactez-nous avec ce que vous avez.
Questions fréquentes
Quand Claude Fable 5.2 est-il sorti ?
Anthropic a publié Claude Fable 5.2 et Claude Mythos 5.2 le lundi 9 novembre 2026.
Combien coûte Claude Fable 5.2 ?
Sur l'API, $8 par million de tokens en entrée et $40 par million en sortie, soit 20 % de moins que Fable 5.1. Le mode rapide coûte $16 et $80. Dans les applications Claude, il est inclus dans les formules Pro (avec des crédits d'utilisation), Max, Ultra, Team et Enterprise.
Claude Fable 5.2 est-il meilleur qu'Opus 5.5 pour le code ?
Sur les benchmarks d'Anthropic, il obtient un meilleur score. Dans notre test sur deux vrais bugs de tous les jours, les deux ont trouvé la cause racine et Opus 5.5 a coûté moins de la moitié, donc pour le travail courant nous choisirions Opus 5.5.
Quelle est la différence entre Fable 5.2 et Mythos 5.2 ?
Ils partagent le même modèle de base. Mythos 5.2 a des garde-fous moins stricts en cybersécurité et en biologie et n'est disponible que pour des organisations vérifiées ; Fable 5.2 est disponible pour tout le monde.
Puis-je utiliser Claude Fable 5.2 dans Claude Code ?
Oui. Il est disponible dans Claude Code et via l'API sous le nom claude-fable-5-2, avec un mode plus rapide à un prix plus élevé.
Un modèle d'IA peut-il corriger des bugs sans développeur ?
Il peut souvent trouver la cause, comme les deux modèles l'ont fait dans notre test. Un développeur doit quand même vérifier la réponse dans le code, tester la correction et décider si elle peut être mise en production.
Articles similaires
Développement d'application web sur mesure : coût, méthode et pièges à éviter (2026)
Combien coûte une application web sur mesure et où cela déraille-t-il ? Tarifs, exemple chiffré et deux projets réels : Waterleau et RAS Security.

Connecter votre logiciel à Claude ou ChatGPT : ce qu'il faut pour un serveur MCP
Un serveur MCP permet à Claude ou ChatGPT de lire et modifier votre logiciel. Nous en avons bâti un en un jour : 1 338 modifications en 10 jours.
Développeur disparu : comment récupérer votre site web
Votre développeur ne répond plus ou votre agence web est en faillite ? Comment récupérer domaine, hébergement, code et comptes stores, et qui reprend.