LLM กับโมเดล System One: Claude และ ChatGPT เทียบกับ Jev และ SubQ Snap
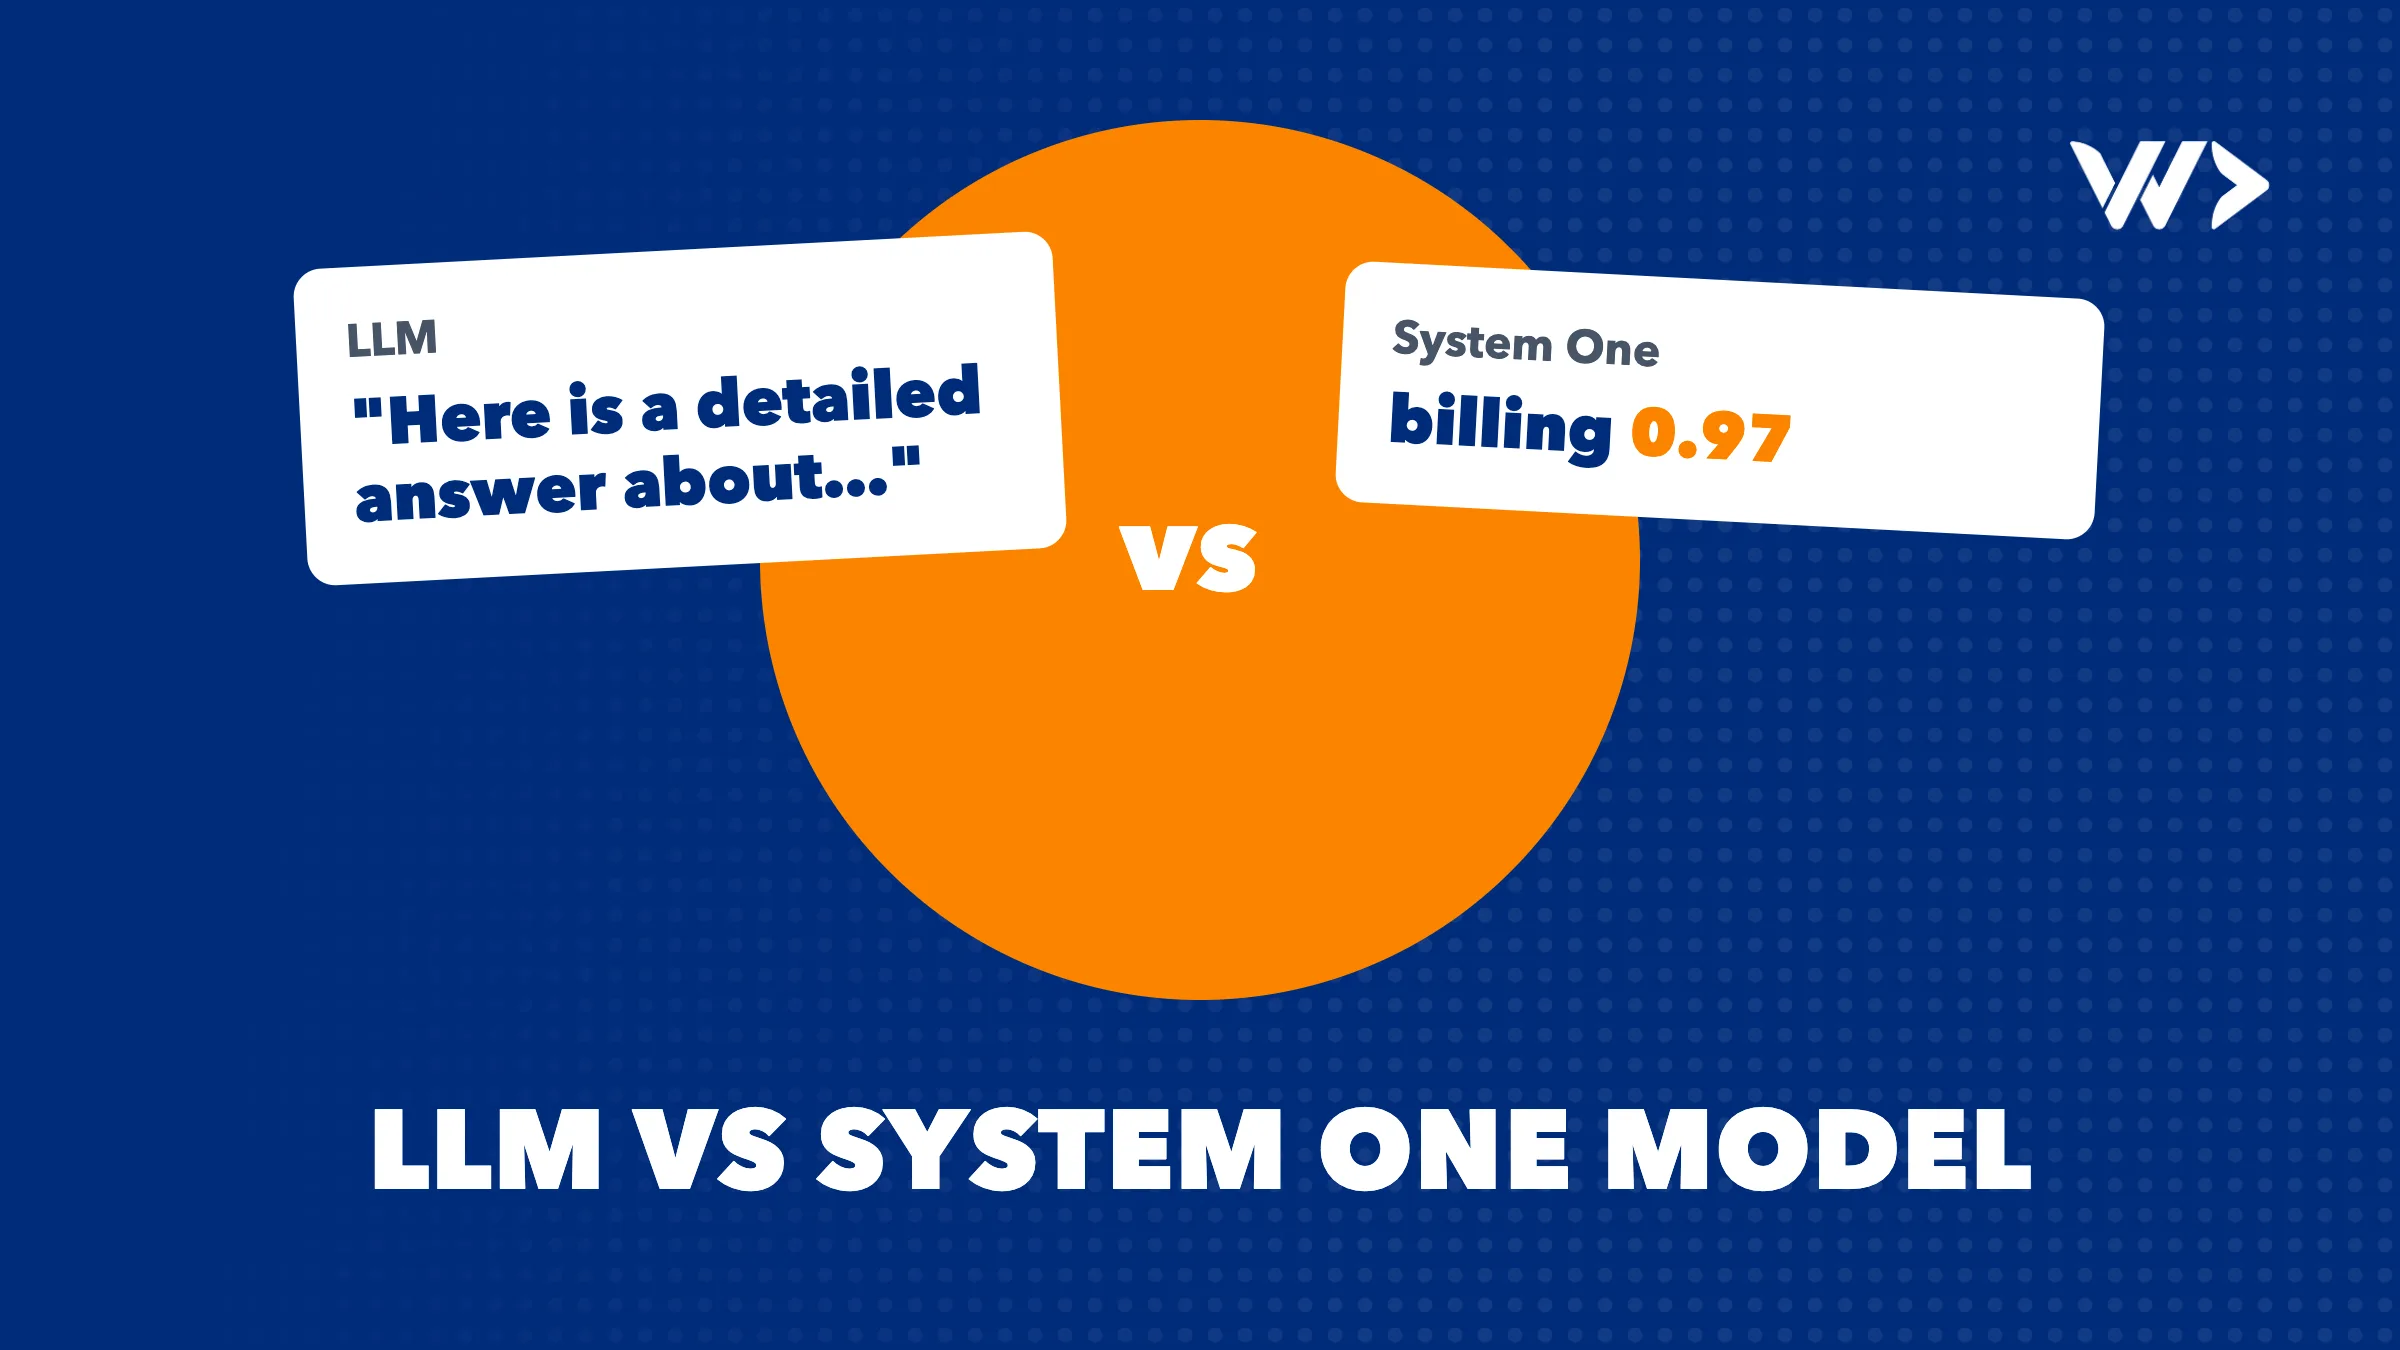
ปัจจุบันคนส่วนใหญ่รู้จักโมเดลภาษาขนาดใหญ่ (LLM) แล้ว คือเมื่อคุณถามอะไรบางอย่างกับ Claude หรือ ChatGPT มันจะเขียนคำตอบให้ ในเดือนกันยายนและตุลาคม 2026 โมเดลอีกประเภทหนึ่งได้ปรากฏขึ้น คือโมเดลตัดสินใจ หรือโมเดล "System One" โดยมี Jev ของ TypeSafe และ SubQ Snap ของ Subquadratic เป็นตัวอย่างแรก โมเดลเหล่านี้ไม่ได้เขียนอะไร แต่เลือกคำตอบ ฟังดูเหมือนเป็นความต่างเล็กน้อย แต่สำหรับซอฟต์แวร์ที่ต้องตัดสินใจเรื่องเล็ก ๆ นับพันครั้งต่อวัน มันเปลี่ยนทั้งความเร็ว ต้นทุน และความน่าเชื่อถือ บทความนี้อธิบายความแตกต่าง และเมื่อไรควรใช้แบบไหน
คำตอบสั้น ๆ
LLM สร้างข้อความ ได้แก่ คำตอบ บทสรุป โค้ด และคำอธิบาย ส่วนโมเดล System One ทำการตัดสินใจที่มีโครงสร้าง คือเลือกจากตัวเลือกที่คุณกำหนด ให้คะแนนตามสเกล หรือตอบใช่หรือไม่ใช่ โดยแต่ละครั้งมาพร้อมความน่าจะเป็น คุณใช้ LLM เมื่อผลลัพธ์เป็นแบบปลายเปิด และใช้โมเดลตัดสินใจเมื่อคำตอบที่เป็นไปได้ทราบล่วงหน้า และคุณต้องการให้เร็ว ราคาถูก และอยู่ในรูปแบบที่โค้ดของคุณนำไปใช้ได้โดยตรง ในผลิตภัณฑ์จำนวนมาก การตั้งค่าที่ดีที่สุดคือใช้ทั้งสองแบบ
LLM ทำอะไร
โมเดลภาษาขนาดใหญ่อย่าง Claude หรือ ChatGPT ทำนายข้อความทีละโทเคน ทำให้ยืดหยุ่นมาก มันเขียนอีเมล อธิบายสัญญา ร่างโค้ด หรือใช้เหตุผลแก้ปัญหาทีละขั้นได้ แต่อีกด้านหนึ่งคือทุกคำตอบเป็นข้อความที่ถูกสร้างขึ้น หากซอฟต์แวร์ของคุณแค่ต้องรู้ว่า "นี่เป็นคำถามเรื่องการเรียกเก็บเงินหรือเรื่องเทคนิค" คุณก็ยังต้องจ่ายเงินและรอคำตอบที่ถูกสร้างขึ้น แล้วยังต้องแยกวิเคราะห์ผลลัพธ์นั้นอีก
โมเดล System One ทำอะไร
TypeSafe อธิบายว่าโมเดล System One คือ "โมเดล AI กลุ่มหนึ่งที่สร้างขึ้นเพื่อตัดสินใจอย่างรวดเร็วและมีโครงสร้าง ซึ่งซอฟต์แวร์นำไปใช้ได้โดยตรง" แทนที่จะเขียนคำตอบ โมเดลจะอ่านอินพุตของคุณแล้วส่งคืนคำตอบที่มีชนิดข้อมูลกำกับพร้อมความน่าจะเป็น Jev มีหน่วยพื้นฐานสามอย่าง:
- Choice: ตัวเลือกใดที่ใช้ได้ เช่น ทีมใดควรรับเรื่องตั๋วนี้
- Score: อินพุตอยู่ตรงไหนบนสเกลที่คุณกำหนด
- Noul: ข้อความแบบใช่/ไม่ใช่นั้นมีโอกาสเป็นจริงเพียงใด
SubQ Snap ทำงานในลักษณะเดียวกัน คือเลือกจากชุดคำตอบที่กำหนดไว้ล่วงหน้าแทนการสร้างข้อความ และ Subquadratic มุ่งใช้กับการตัดสินใจภายในเอเจนต์ AI เช่น ไฟล์ใดเกี่ยวข้อง ควรใช้เครื่องมือใด การตรวจสอบผ่านหรือไม่ และเมื่อไรควรหยุดหรือส่งต่อ
ชื่อนี้มาจาก "System 1" ของ Daniel Kahneman คือโหมดการคิดที่รวดเร็วและใช้สัญชาตญาณ ตรงข้ามกับ "System 2" ที่ช้าและรอบคอบ โมเดลตัดสินใจจัดการการตัดสินที่ต้องการความเร็ว ส่วน LLM สายให้เหตุผลจัดการการคิด
เปรียบเทียบแบบเคียงข้างกัน
| LLM (เช่น Claude, ChatGPT) | Jev (TypeSafe) | SubQ Snap (Subquadratic) | |
|---|---|---|---|
| ผลลัพธ์ | ข้อความ โค้ด และคำอธิบายที่สร้างขึ้น | Choice, score หรือใช่/ไม่ใช่ พร้อมความน่าจะเป็น | ตัวเลือกหนึ่งจากคำตอบที่กำหนดไว้ล่วงหน้า |
| อินพุต | ข้อความ และในหลายโมเดลรวมถึงรูปภาพและไฟล์ | ข้อความและ JSON เท่านั้น | ข้อความและรูปภาพ |
| คอนเท็กซ์ | แตกต่างกันไปตามโมเดล | 64k โทเคนต่อคำขอ, 32k ต่อคำถาม | สูงสุด 384k โทเคนในการเรียกครั้งเดียว |
| ราคา (ณ ตุลาคม 2026) | ตัวอย่าง: Claude Opus 5.5 ราคา $4 ต่อโทเคนอินพุตหนึ่งล้าน และ $20 ต่อโทเคนเอาต์พุตหนึ่งล้าน | $0.042 ต่อโทเคนอินพุตหนึ่งล้าน เอาต์พุตไม่คิดเงิน | $0.05 ต่อโทเคนอินพุตหนึ่งล้าน เอาต์พุตไม่คิดเงิน |
| อธิบายเหตุผลของตัวเอง | ได้ | ไม่ได้ | ไม่ได้ |
| ความพร้อมใช้งาน | เปิดให้ใช้งานทั่วไป | เวอร์ชันใช้งานจริง (jev-1.13), พรีวิวของ 1.14 ตั้งแต่ 14 ตุลาคม 2026 | พรีวิวสาธารณะ ความจุจำกัด |
| เหมาะที่สุดสำหรับ | การเขียน การให้เหตุผล งานปลายเปิด | การจัดเส้นทางปริมาณมาก ระบบป้องกัน และการให้คะแนน | การตัดสินใจกับเอกสารยาวและขั้นตอนของเอเจนต์ |
ส่วนที่โดดเด่นคือความต่างของราคา ต่อโทเคนอินพุตหนึ่งล้าน โมเดลตัดสินใจเหล่านี้มีราคาประมาณหนึ่งในร้อยของ LLM ระดับแนวหน้าขนาดใหญ่ และไม่คิดค่าเอาต์พุตเลย สำหรับการตัดสินใจครั้งเดียวแทบไม่มีความหมาย แต่สำหรับการตัดสินใจหลายล้านครั้งต่อเดือน มันคือความต่างระหว่างเศษปัดกับรายจ่ายก้อนจริง
ทำงานร่วมกันอย่างไร
โมเดลตัดสินใจไม่ได้มาแทนที่ LLM แต่เป็นตัวกรองด้านหน้ามัน การตั้งค่าทั่วไปสำหรับงานซัพพอร์ตลูกค้า:
- โมเดลตัดสินใจอ่านข้อความที่เข้ามาแต่ละข้อความและตัดสินว่า เป็นเรื่องการเรียกเก็บเงิน เทคนิค การขาย หรือสแปม และเร่งด่วนหรือไม่
- กรณีง่ายและมั่นใจได้จะถูกจัดเส้นทางอัตโนมัติด้วยโค้ดของคุณเอง
- กรณีที่โมเดลไม่แน่ใจ หรือที่ต้องมีคำตอบที่เขียนขึ้น จะส่งไปยัง LLM หรือบุคคล
รูปแบบเดียวกันใช้ได้ภายในเอเจนต์ AI ด้วย คือให้โมเดลตัดสินใจเลือกเครื่องมือ ตรวจผลลัพธ์ และตัดสินว่าจะหยุดหรือไม่ แล้วเรียกใช้โมเดลให้เหตุผลราคาแพงเฉพาะขั้นตอนที่จำเป็นจริง ๆ ซึ่งตรงกับบทบาทที่ทั้ง TypeSafe และ Subquadratic อธิบายไว้สำหรับโมเดลของตน
Jev หรือ SubQ Snap?
ทั้งสองเป็น API แบบโฮสต์ที่ส่งคืนการตัดสินใจและคิดเงินเฉพาะอินพุต ความแตกต่างหลัก ๆ จากหน้าเว็บของผู้พัฒนาเอง:
- คอนเท็กซ์: Snap อ่านข้อความและรูปภาพได้สูงสุด 384k โทเคนในการเรียกครั้งเดียว ส่วน Jev รับ 64k ต่อคำขอ เฉพาะข้อความและ JSON
- เบนช์มาร์ก: Subquadratic รายงานว่า Snap ได้ 61.7 เทียบกับ 57.9 ของ Jev บน Decision Index 0.2.1 และนำใน 13 จาก 16 เบนช์มาร์กระดับองค์กร ขณะที่ Jev ยังนำในงานการใช้เครื่องมือบางอย่าง นี่เป็นตัวเลขของผู้พัฒนาเองบนเบนช์มาร์กที่ผู้พัฒนาเลือก
- ความสมบูรณ์: Jev มีเวอร์ชันใช้งานจริง ส่วน Snap อยู่ในพรีวิวสาธารณะและมีความจุจำกัด
หากการตัดสินใจของคุณเกี่ยวกับอินพุตสั้น ๆ เช่น ข้อความ ตั๋ว หรือช่องในแบบฟอร์ม Jev เป็นตัวเลือกที่มั่นคงกว่า หากเกี่ยวกับเอกสารยาว สัญญา หรือภาพหน้าจอ Snap สร้างมาเพื่อสิ่งนั้น
เมื่อไรควรใช้แบบไหน
- ใช้ LLM เมื่อคำตอบเป็นแบบปลายเปิด เช่น การเขียน การสรุป การอธิบาย การเขียนโค้ด หรือการใช้เหตุผลกับเรื่องใหม่
- ใช้โมเดลตัดสินใจ เมื่อคุณระบุคำตอบที่เป็นไปได้ล่วงหน้าได้ ต้องการการตัดสินใจจำนวนมากอย่างรวดเร็วและราคาถูก และโค้ดของคุณทำงานต่อจากผลลัพธ์
- ใช้ทั้งสอง เมื่อคุณต้องการความเร็วและต้นทุนต่ำสำหรับกรณีส่วนใหญ่ และความลึกของ LLM สำหรับกรณียาก
สิ่งที่ควรระวัง
- ใหม่มาก ทั้งสองโมเดลเพิ่งเปิดตัวในช่วงไม่กี่สัปดาห์ที่ผ่านมา เวอร์ชัน ราคา และเบนช์มาร์กจะเปลี่ยนไป
- ตัวเลขของผู้พัฒนาก็คือตัวเลขของผู้พัฒนา ทดสอบกับข้อมูลของคุณเองก่อนเชื่อเบนช์มาร์ก
- ความน่าจะเป็นไม่ใช่การรับประกัน TypeSafe เองก็ระบุว่าการสอบเทียบวัดจากกลุ่มของการทำนาย และไม่รับประกันว่าคำตอบแต่ละข้อจะถูกต้อง ควรออกแบบเส้นทางส่งต่อสำหรับกรณีที่ไม่แน่ใจ
- ไม่มีคำอธิบาย โมเดลตัดสินใจบอกคุณว่าอะไร แต่ไม่บอกว่าทำไม หากต้องการร่องรอยการตรวจสอบด้วยภาษาที่เข้าใจง่าย ให้มี LLM หรือบุคคลร่วมอยู่ในกระบวนการ
เริ่มต้นที่ไหน
มองหาการตัดสินใจที่ผลิตภัณฑ์หรือทีมของคุณทำซ้ำแล้วซ้ำอีก เช่น การจัดเส้นทางข้อความ การติดธงเนื้อหาเสี่ยง การตรวจว่าเอกสารครบถ้วนหรือไม่ สิ่งเหล่านี้คือตัวเลือกแรกสำหรับโมเดลตัดสินใจ หากต้องการความช่วยเหลือในการเลือกโมเดลที่เหมาะสมและผสานเข้ากับซอฟต์แวร์ของคุณ ดูงานการพัฒนา AIของเรา หรืออ่านเพิ่มเติมเกี่ยวกับการพัฒนา AI คืออะไรและAI มีต้นทุนจริงเท่าไร
แหล่งที่มา
คำถามที่พบบ่อย
โมเดล System One คืออะไร
โมเดลที่ตัดสินใจอย่างรวดเร็วและมีโครงสร้างให้ซอฟต์แวร์ โดยส่งคืน choice, score หรือคำตอบใช่/ไม่ใช่พร้อมความน่าจะเป็น แทนข้อความที่ถูกสร้างขึ้น ชื่อนี้มาจากการคิดแบบ System 1 ที่รวดเร็วและใช้สัญชาตญาณของ Kahneman
LLM กับโมเดลตัดสินใจต่างกันอย่างไร
LLM อย่าง Claude หรือ ChatGPT เขียนข้อความ โค้ด และคำอธิบายแบบปลายเปิด ส่วนโมเดลตัดสินใจอย่าง Jev หรือ SubQ Snap เลือกจากคำตอบที่คุณกำหนดเท่านั้น จึงเร็วกว่าและถูกกว่าสำหรับการจัดเส้นทาง การให้คะแนน และการตรวจสอบ
Jev และ SubQ Snap ราคาเท่าไร
ณ ตุลาคม 2026 Jev ราคา $0.042 ต่อโทเคนอินพุตหนึ่งล้าน และ SubQ Snap $0.05 ต่อโทเคนอินพุตหนึ่งล้าน ทั้งสองไม่คิดค่าโทเคนเอาต์พุต
SubQ Snap ดีกว่า Jev หรือไม่
Subquadratic รายงานคะแนนของ Snap ที่สูงกว่าในเบนช์มาร์กส่วนใหญ่ที่ผู้พัฒนาเลือก และคอนเท็กซ์ที่ใหญ่กว่ามาก (384k เทียบกับ 64k โทเคน) แต่ Jev มีเวอร์ชันใช้งานจริง ขณะที่ Snap อยู่ในพรีวิวสาธารณะ ควรทดสอบทั้งสองกับข้อมูลของคุณเอง
โมเดลตัดสินใจแทนที่ ChatGPT หรือ Claude ได้ไหม
ไม่ได้ มันแทนที่ LLM ได้เฉพาะการตัดสินใจที่มีขอบเขต สำหรับการเขียน อธิบาย เขียนโค้ด และให้เหตุผล คุณยังต้องใช้ LLM ทั้งสองแบบทำงานได้ดีที่สุดเมื่อใช้ร่วมกัน
บทความที่เกี่ยวข้อง
ผลิตภัณฑ์ที่ทำด้วย Vibe Coding พร้อมให้ผู้ใช้จริงหรือยัง? เช็กลิสต์ก่อนเปิดตัว
สร้างผลิตภัณฑ์ด้วย Lovable, Bolt, Cursor หรือ Claude? ตรวจเรื่อง secret การเข้าถึงข้อมูล การชำระเงิน แบ็กอัป monitoring ความเป็นส่วนตัว และความเป็นเจ้าของโค้ด ก่อนเปิดตัว

.NET กับ Java ในปี 2026: ศึกเดิมกลับมาอีกแล้ว
.NET 10 เทียบ Java 25 ในเดือนตุลาคม 2026: เวอร์ชัน วันสิ้นสุดการสนับสนุน concurrency หน่วยความจำ เฟรมเวิร์ก และหลักเกณฑ์ง่าย ๆ สำหรับเลือกแพลตฟอร์ม


Python vs Node.js ในปี 2026: ควรเลือกใช้ตัวไหน?
เปรียบเทียบ Python กับ Node.js ปี 2026: ระบบนิเวศ ประสิทธิภาพ AI การรองรับ TypeScript เวอร์ชันปัจจุบัน ตารางเปรียบเทียบ และหลักเกณฑ์การเลือกที่ชัดเจน