LLM vs modèle System One : Claude et ChatGPT face à Jev et SubQ Snap
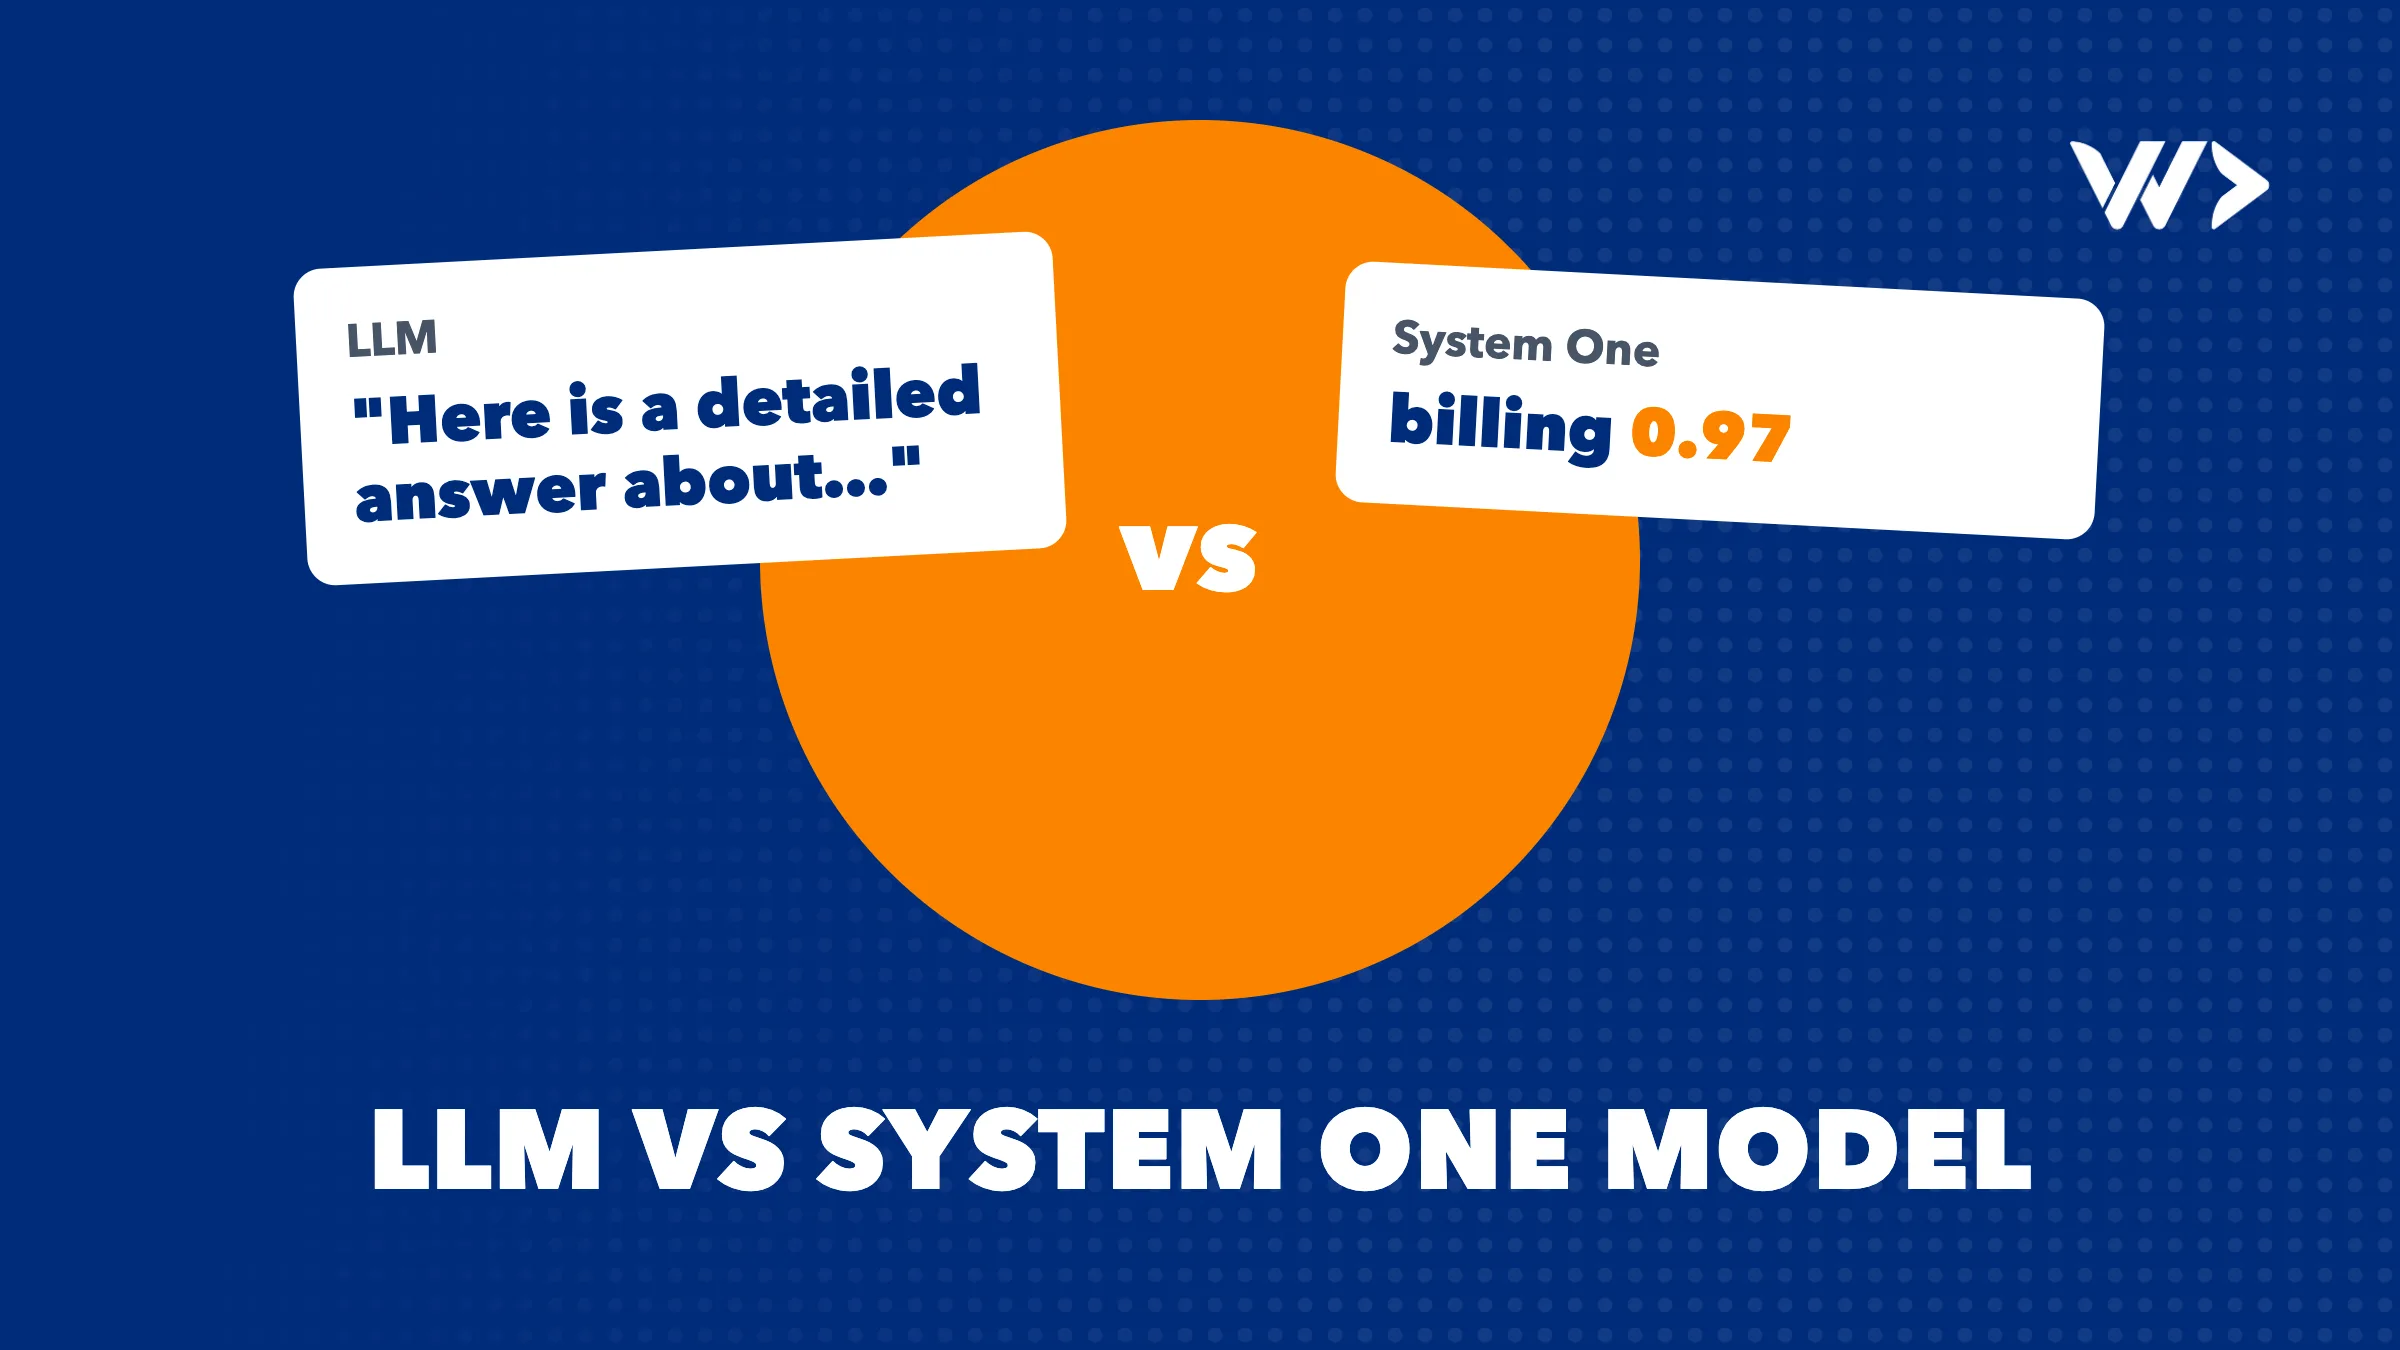
La plupart des gens savent désormais ce qu'est un grand modèle de langage : vous posez une question à Claude ou ChatGPT, et il rédige une réponse. En septembre et octobre 2026, un autre type de modèle est apparu : le modèle de décision, ou modèle « System One », avec Jev de TypeSafe et SubQ Snap de Subquadratic comme premiers exemples. Ils n'écrivent rien. Ils choisissent une réponse. Cela peut sembler une petite différence, mais pour un logiciel qui doit prendre des milliers de petites décisions par jour, cela change la vitesse, le coût et la fiabilité. Cet article explique la différence, et quand utiliser l'un ou l'autre.
La réponse courte
Un LLM génère du texte : réponses, résumés, code, explications. Un modèle System One prend une décision structurée : il choisit parmi des options que vous définissez, donne une note sur une échelle, ou répond par oui ou non, chaque fois avec une probabilité. Vous utilisez un LLM quand le résultat est ouvert. Vous utilisez un modèle de décision quand les réponses possibles sont connues à l'avance et que vous les voulez rapides, peu coûteuses et sous une forme que votre code peut exploiter directement. Dans beaucoup de produits, la meilleure configuration utilise les deux.
Ce que fait un LLM
Un grand modèle de langage tel que Claude ou ChatGPT prédit du texte, token par token. Cela le rend extrêmement flexible : il peut rédiger un e-mail, expliquer un contrat, écrire du code ou raisonner sur un problème étape par étape. Revers de la médaille : chaque réponse est du texte généré. Si votre logiciel a seulement besoin de savoir « s'agit-il d'une question de facturation ou d'une question technique ? », vous payez et attendez quand même une réponse générée, puis vous devez l'analyser.
Ce que fait un modèle System One
TypeSafe décrit les modèles System One comme « une classe de modèles d'IA conçus pour prendre des décisions rapides et structurées que les logiciels peuvent utiliser directement ». Au lieu d'écrire une réponse, le modèle lit votre entrée et renvoie une réponse typée accompagnée d'une probabilité. Jev propose trois primitives :
- Choice : quelle option s'applique, par exemple quelle équipe doit traiter un ticket.
- Score : où se situe l'entrée sur une échelle que vous définissez.
- Noul : quelle est la probabilité qu'une affirmation oui/non soit vraie.
SubQ Snap fonctionne de la même manière : il choisit parmi un ensemble de réponses prédéfinies plutôt que de générer du texte, et Subquadratic le destine aux décisions au sein d'agents IA, par exemple quel fichier est pertinent, quel outil utiliser, si une vérification a réussi, et quand s'arrêter ou escalader.
Le nom vient du « Système 1 » de Daniel Kahneman : le mode de pensée rapide et intuitif, par opposition au « Système 2 », lent et délibéré. Un modèle de décision gère les jugements rapides ; un LLM de raisonnement gère la réflexion.
Comparaison côte à côte
| LLM (p. ex. Claude, ChatGPT) | Jev (TypeSafe) | SubQ Snap (Subquadratic) | |
|---|---|---|---|
| Sortie | Texte généré, code, explications | Choice, score ou oui/non, avec probabilités | Un choix parmi des réponses prédéfinies |
| Entrée | Texte, et pour de nombreux modèles images et fichiers | Texte et JSON uniquement | Texte et images |
| Contexte | Variable selon le modèle | 64k tokens par requête, 32k par question | Jusqu'à 384k tokens en un seul appel |
| Prix (en octobre 2026) | Exemple : Claude Opus 5.5 à 4 $ par million de tokens en entrée et 20 $ par million en sortie | 0,042 $ par million de tokens en entrée, sortie gratuite | 0,05 $ par million de tokens en entrée, sortie gratuite |
| Explique son raisonnement | Oui | Non | Non |
| Disponibilité | Disponibilité générale | Production (jev-1.13), préversion de la 1.14 à partir du 14 octobre 2026 | Préversion publique, capacité limitée |
| Idéal pour | Rédaction, raisonnement, tâches ouvertes | Routage à grand volume, garde-fous et notation | Décisions sur de longs documents et étapes d'agents |
La différence de prix est frappante : par million de tokens en entrée, ces modèles de décision coûtent environ un centième d'un grand LLM de pointe, et ils ne facturent pas du tout la sortie. Pour une décision isolée, cela n'a guère d'importance. Pour des millions de décisions par mois, c'est la différence entre une erreur d'arrondi et un vrai poste de dépenses.
Comment ils fonctionnent ensemble
Un modèle de décision ne remplace pas un LLM. C'est un filtre placé devant lui. Une configuration typique pour le support client :
- Un modèle de décision lit chaque message entrant et décide : facturation, technique, vente ou spam ? Urgent ou non ?
- Les cas simples et sûrs sont routés automatiquement par votre propre code.
- Les cas où le modèle est incertain, ou où une réponse rédigée est nécessaire, vont à un LLM ou à une personne.
Le même schéma fonctionne au sein des agents IA : laissez le modèle de décision choisir l'outil, vérifier le résultat et décider s'il faut s'arrêter, et ne faites appel au coûteux modèle de raisonnement que pour les étapes qui en ont vraiment besoin. C'est exactement le rôle que TypeSafe et Subquadratic décrivent pour leurs modèles.
Jev ou SubQ Snap ?
Les deux sont des API hébergées qui renvoient des décisions et ne facturent que l'entrée. Les principales différences, d'après les pages des éditeurs eux-mêmes :
- Contexte : Snap lit jusqu'à 384k tokens de texte et d'images en un seul appel ; Jev accepte 64k par requête, texte et JSON uniquement.
- Benchmarks : Subquadratic indique que Snap obtient 61,7 contre 57,9 pour Jev sur Decision Index 0.2.1, et mène sur 13 des 16 benchmarks d'entreprise, tandis que Jev reste en tête sur certaines tâches d'utilisation d'outils. Ce sont les chiffres de l'éditeur, sur des benchmarks qu'il a choisis.
- Maturité : Jev dispose d'une version de production ; Snap est en préversion publique avec une capacité limitée.
Si vos décisions portent sur de courtes entrées comme des messages, des tickets ou des champs de formulaire, Jev est le choix le plus établi. Si elles concernent de longs documents, des contrats ou des captures d'écran, Snap est conçu pour cela.
Quand utiliser lequel
- Utilisez un LLM quand la réponse est ouverte : rédiger, résumer, expliquer, coder, ou raisonner sur quelque chose de nouveau.
- Utilisez un modèle de décision quand vous pouvez lister les réponses possibles à l'avance, que vous avez besoin de nombreuses décisions rapidement et à bas coût, et que votre code agit sur le résultat.
- Utilisez les deux quand vous voulez de la vitesse et un faible coût pour la majorité des cas, et la profondeur d'un LLM pour les cas difficiles.
Points de vigilance
- C'est très récent. Les deux modèles ont été lancés ces dernières semaines ; les versions, les prix et les benchmarks vont évoluer.
- Les chiffres d'un éditeur restent les chiffres d'un éditeur. Testez sur vos propres données avant de vous fier à un benchmark.
- Les probabilités ne sont pas des garanties. TypeSafe précise lui-même que la calibration est mesurée sur des groupes de prédictions et ne garantit pas qu'une réponse individuelle soit correcte. Prévoyez un circuit d'escalade pour les cas incertains.
- Pas d'explications. Un modèle de décision vous dit quoi, pas pourquoi. Là où il vous faut une piste d'audit en langage clair, gardez un LLM ou une personne dans la boucle.
Par où commencer
Repérez les décisions que votre produit ou votre équipe prend encore et encore : router des messages, signaler un contenu à risque, vérifier qu'un document est complet. Ce sont les premiers candidats pour un modèle de décision. Si vous souhaitez de l'aide pour choisir le bon modèle et l'intégrer à votre logiciel, consultez notre travail de développement IA, ou lisez-en plus sur ce qu'implique le développement IA et ce que l'IA coûte réellement.
Sources
Questions fréquentes
Qu'est-ce qu'un modèle System One ?
Un modèle qui prend des décisions rapides et structurées pour des logiciels : il renvoie un choice, un score ou une réponse oui/non avec une probabilité, au lieu de texte généré. Le nom vient du Système 1 de Kahneman, la pensée rapide et intuitive.
Quelle est la différence entre un LLM et un modèle de décision ?
Un LLM comme Claude ou ChatGPT rédige du texte, du code et des explications ouverts. Un modèle de décision comme Jev ou SubQ Snap se contente de choisir parmi des réponses que vous définissez, ce qui le rend plus rapide et moins cher pour le routage, la notation et les vérifications.
Combien coûtent Jev et SubQ Snap ?
En octobre 2026, Jev coûte 0,042 $ par million de tokens en entrée et SubQ Snap 0,05 $ par million de tokens en entrée. Aucun des deux ne facture les tokens en sortie.
SubQ Snap est-il meilleur que Jev ?
Subquadratic indique des scores plus élevés pour Snap sur la plupart des benchmarks qu'il a choisis et un contexte bien plus grand (384k contre 64k tokens), mais Jev dispose d'une version de production alors que Snap est en préversion publique. Testez les deux sur vos propres données.
Un modèle de décision peut-il remplacer ChatGPT ou Claude ?
Non. Il ne remplace le LLM que pour des décisions bornées. Pour rédiger, expliquer, coder et raisonner, il vous faut toujours un LLM ; les deux fonctionnent mieux ensemble.
Articles similaires
Mon produit « vibe-codé » est-il prêt pour de vrais utilisateurs ? Checklist de lancement
Produit créé avec Lovable, Bolt, Cursor ou Claude ? Vérifiez secrets, accès aux données, paiements, sauvegardes, surveillance, vie privée et propriété du code avant le lancement.

.NET vs. Java en 2026 : c'est reparti
.NET 10 vs Java 25 en octobre 2026 : versions, dates de support, concurrence, mémoire, frameworks et règles empiriques pour choisir une plateforme.


Python vs Node.js en 2026 : lequel utiliser ?
Python vs Node.js comparés pour 2026 : écosystèmes, performance, IA, prise en charge de TypeScript, versions actuelles, tableau comparatif et règles claires pour choisir.