LLM versus System One-model: Claude en ChatGPT tegenover Jev en SubQ Snap
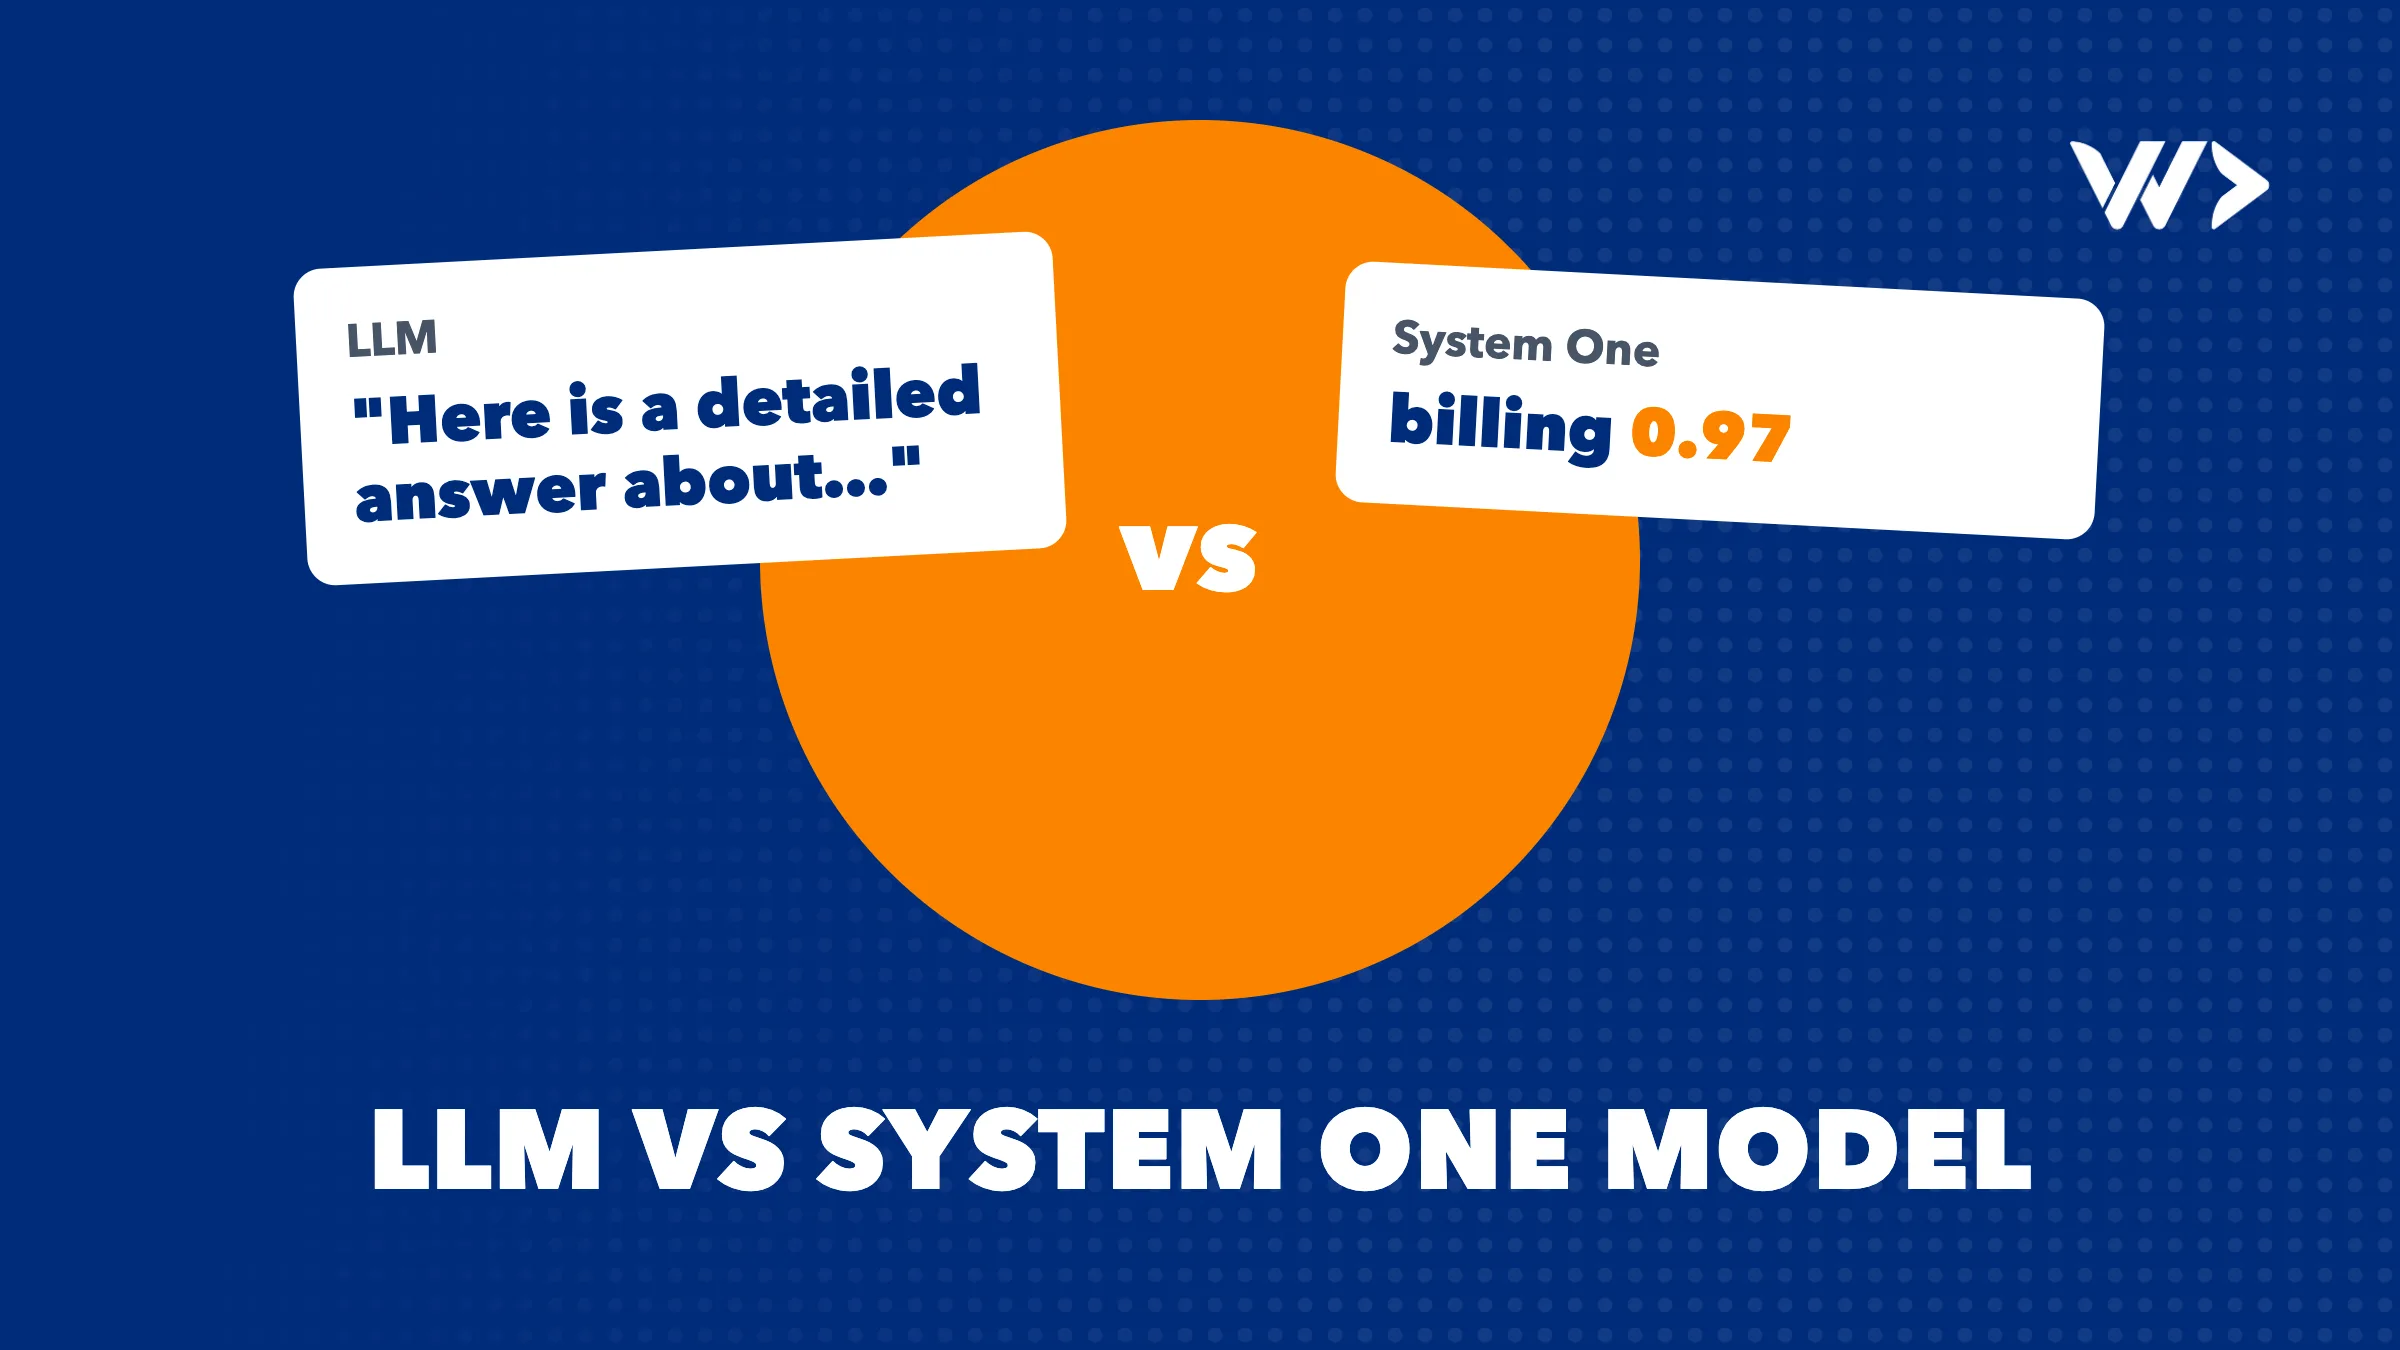
De meeste mensen weten inmiddels wat een groot taalmodel is: je stelt Claude of ChatGPT een vraag en het schrijft een antwoord. In september en oktober 2026 verscheen een ander type model: het beslissingsmodel, of "System One"-model, met Jev van TypeSafe en SubQ Snap van Subquadratic als eerste voorbeelden. Ze schrijven niets. Ze kiezen een antwoord. Dat lijkt een klein verschil, maar voor software die dagelijks duizenden kleine beslissingen moet nemen, verandert het de snelheid, de kosten en de betrouwbaarheid. Dit artikel legt het verschil uit en wanneer je welk model gebruikt.
Het korte antwoord
Een LLM genereert tekst: antwoorden, samenvattingen, code, uitleg. Een System One-model neemt een gestructureerde beslissing: het kiest uit opties die je zelf definieert, geeft een score op een schaal of antwoordt met ja of nee, telkens met een waarschijnlijkheid. Je gebruikt een LLM wanneer de uitvoer open is. Je gebruikt een beslissingsmodel wanneer de mogelijke antwoorden vooraf bekend zijn en je ze snel, goedkoop en in een vorm wilt die je code rechtstreeks kan gebruiken. In veel producten gebruikt de beste opzet allebei.
Wat een LLM doet
Een groot taalmodel zoals Claude of ChatGPT voorspelt tekst, token per token. Dat maakt het enorm flexibel: het kan een e-mail schrijven, een contract uitleggen, code opstellen of stap voor stap een probleem doordenken. Keerzijde is dat elk antwoord gegenereerde tekst is. Als je software alleen wil weten "is dit een factuurvraag of een technische vraag?", betaal en wacht je toch op een gegenereerd antwoord, dat je daarna nog moet verwerken.
Wat een System One-model doet
TypeSafe omschrijft System One-modellen als "een klasse van AI-modellen die gebouwd zijn om snelle, gestructureerde beslissingen te nemen die software rechtstreeks kan gebruiken". In plaats van een antwoord te schrijven leest het model je invoer en geeft het een getypeerd antwoord met een waarschijnlijkheid terug. Jev biedt drie bouwstenen:
- Choice: welke optie van toepassing is, bijvoorbeeld welk team een ticket moet behandelen.
- Score: waar de invoer valt op een schaal die je zelf bepaalt.
- Noul: hoe waarschijnlijk een ja/nee-bewering waar is.
SubQ Snap werkt op dezelfde manier: het kiest uit een vooraf bepaalde set antwoorden in plaats van tekst te genereren, en Subquadratic richt het op beslissingen binnen AI-agents, zoals welk bestand relevant is, welke tool je gebruikt, of een controle geslaagd is, en wanneer je moet stoppen of opschalen.
De naam komt van "System 1" van Daniel Kahneman: de snelle, intuïtieve denkwijze, tegenover het trage, weloverwogen "System 2". Een beslissingsmodel neemt de snelle oordelen voor zijn rekening; een redenerend LLM doet het denkwerk.
Naast elkaar
| LLM (bv. Claude, ChatGPT) | Jev (TypeSafe) | SubQ Snap (Subquadratic) | |
|---|---|---|---|
| Uitvoer | Gegenereerde tekst, code, uitleg | Choice, score of ja/nee, met waarschijnlijkheden | Een keuze uit vooraf bepaalde antwoorden |
| Invoer | Tekst, en bij veel modellen ook afbeeldingen en bestanden | Alleen tekst en JSON | Tekst en afbeeldingen |
| Context | Verschilt per model | 64k tokens per aanvraag, 32k per vraag | Tot 384k tokens in één aanroep |
| Prijs (stand oktober 2026) | Voorbeeld: Claude Opus 5.5 aan $4 per miljoen invoertokens en $20 per miljoen uitvoertokens | $0.042 per miljoen invoertokens, uitvoer gratis | $0.05 per miljoen invoertokens, uitvoer gratis |
| Legt zijn redenering uit | Ja | Nee | Nee |
| Beschikbaarheid | Algemeen beschikbaar | Productie (jev-1.13), preview van 1.14 vanaf 14 oktober 2026 | Publieke preview, beperkte capaciteit |
| Het best voor | Schrijven, redeneren, open taken | Routering, guardrails en scoring in grote volumes | Beslissingen over lange documenten en agentstappen |
Het prijsverschil springt in het oog: per miljoen invoertokens kosten deze beslissingsmodellen ongeveer een honderdste van een groot frontier-LLM, en ze rekenen helemaal niets aan voor uitvoer. Voor één enkele beslissing maakt dat nauwelijks uit. Bij miljoenen beslissingen per maand is het het verschil tussen een afrondingsfout en een echte kostenpost.
Hoe ze samenwerken
Een beslissingsmodel is geen vervanging voor een LLM. Het is een filter ervoor. Een typische opzet voor klantenondersteuning:
- Een beslissingsmodel leest elk binnenkomend bericht en beslist: facturatie, technisch, verkoop of spam? Dringend of niet?
- Eenvoudige, zekere gevallen worden automatisch doorgestuurd door je eigen code.
- Gevallen waarbij het model onzeker is, of waarvoor een geschreven antwoord nodig is, gaan naar een LLM of naar een persoon.
Hetzelfde patroon werkt binnen AI-agents: laat het beslissingsmodel de tool kiezen, het resultaat controleren en beslissen of er gestopt moet worden, en roep het dure redeneermodel alleen aan voor de stappen die het echt nodig hebben. Dat is precies de rol die zowel TypeSafe als Subquadratic voor hun modellen beschrijven.
Jev of SubQ Snap?
Beide zijn gehoste API's die beslissingen teruggeven en alleen voor invoer rekenen. De belangrijkste verschillen, volgens de pagina's van de aanbieders zelf:
- Context: Snap leest tot 384k tokens aan tekst en afbeeldingen in één aanroep; Jev neemt 64k per aanvraag, alleen tekst en JSON.
- Benchmarks: Subquadratic meldt dat Snap 61,7 scoort tegenover 57,9 voor Jev op Decision Index 0.2.1, en voorop loopt op 13 van de 16 enterprise-benchmarks, terwijl Jev bij sommige tool-use-taken voorblijft. Dit zijn de eigen cijfers van de aanbieder op benchmarks die hij zelf koos.
- Volwassenheid: Jev heeft een productieversie; Snap zit in publieke preview met beperkte capaciteit.
Gaat het bij je beslissingen om korte invoer zoals berichten, tickets of formuliervelden, dan is Jev de meer gevestigde keuze. Gaat het om lange documenten, contracten of screenshots, dan is Snap daarvoor gebouwd.
Wanneer welk model?
- Gebruik een LLM wanneer het antwoord open is: schrijven, samenvatten, uitleggen, programmeren of redeneren over iets nieuws.
- Gebruik een beslissingsmodel wanneer je de mogelijke antwoorden vooraf kan opsommen, je veel beslissingen snel en goedkoop nodig hebt en je code op het resultaat handelt.
- Gebruik allebei wanneer je snelheid en lage kosten wil voor het gros van de gevallen, en de diepgang van een LLM voor de moeilijke.
Waar je op moet letten
- Het is heel nieuw. Beide modellen zijn pas de voorbije weken gelanceerd; versies, prijzen en benchmarks zullen veranderen.
- Cijfers van aanbieders blijven cijfers van aanbieders. Test op je eigen data voor je een benchmark vertrouwt.
- Waarschijnlijkheden zijn geen garanties. TypeSafe merkt zelf op dat kalibratie gemeten wordt over groepen voorspellingen en niet garandeert dat een individueel antwoord juist is. Ontwerp een escalatiepad voor onzekere gevallen.
- Geen uitleg. Een beslissingsmodel vertelt je wat, niet waarom. Waar je een controlespoor in gewone taal nodig hebt, hou je een LLM of een persoon in de lus.
Waar beginnen?
Zoek de beslissingen die je product of team telkens opnieuw neemt: berichten routeren, riskante inhoud markeren, nagaan of een document volledig is. Dat zijn de eerste kandidaten voor een beslissingsmodel. Wil je hulp bij het kiezen van het juiste model en het inbouwen ervan in je software, bekijk dan ons werk rond AI-ontwikkeling, of lees meer over wat AI-ontwikkeling inhoudt en wat AI echt kost.
Bronnen
Veelgestelde vragen
Wat is een System One-model?
Een model dat snelle, gestructureerde beslissingen neemt voor software: het geeft een choice, een score of een ja/nee-antwoord met een waarschijnlijkheid terug in plaats van gegenereerde tekst. De naam komt van het snelle, intuïtieve System 1-denken van Kahneman.
Wat is het verschil tussen een LLM en een beslissingsmodel?
Een LLM zoals Claude of ChatGPT schrijft open tekst, code en uitleg. Een beslissingsmodel zoals Jev of SubQ Snap kiest enkel uit antwoorden die jij definieert, waardoor het sneller en goedkoper is voor routering, scoring en controles.
Wat kosten Jev en SubQ Snap?
In oktober 2026 kost Jev $0.042 per miljoen invoertokens en SubQ Snap $0.05 per miljoen invoertokens. Geen van beide rekent uitvoertokens aan.
Is SubQ Snap beter dan Jev?
Subquadratic meldt hogere scores voor Snap op de meeste door hen gekozen benchmarks en een veel grotere context (384k tegenover 64k tokens), maar Jev heeft een productieversie terwijl Snap in publieke preview zit. Test beide op je eigen data.
Kan een beslissingsmodel ChatGPT of Claude vervangen?
Nee. Het vervangt de LLM enkel voor afgebakende beslissingen. Voor schrijven, uitleggen, programmeren en redeneren heb je nog altijd een LLM nodig; de twee werken het best samen.
Gerelateerde artikelen
Is mijn vibe-coded product klaar voor echte gebruikers? Een lanceringschecklist
Product gebouwd met Lovable, Bolt, Cursor of Claude? Controleer geheimen, datatoegang, betalingen, back-ups, monitoring, privacy en code-eigendom vóór je lanceert.

.NET vs. Java in 2026: daar gaan we weer
.NET 10 vs Java 25 in oktober 2026: versies, supportdata, concurrency, geheugen, frameworks en vuistregels om een platform te kiezen.


Python vs Node.js in 2026: welke moet je gebruiken?
Python vs Node.js vergeleken voor 2026: ecosystemen, performance, AI, TypeScript-support, huidige versies, een vergelijkingstabel en duidelijke keuzeregels.