ไม่อยากถาม AI ใช่ไหม? ลองปรึกษา We Do Dev Work ดูสิ

ทุกวันนี้เราหนีไม่พ้นจริงๆ เพราะ AI อยู่ทุกที่ ไม่ว่าจะเป็นโฆษณาจ้างงานบน LinkedIn, AI IDE, ฟีเจอร์ AI ในพื้นที่ทำงาน, เครื่องมือสร้างคอนเทนต์, AI ที่ช่วยเขียนตั๋วงาน หรือแม้แต่การพัฒนาแอปด้วยแพลตฟอร์ม AI no-code
เราเข้าใจดีว่ามีคนจำนวนมากลงทุนในตลาด AI และบริษัทยักษ์ใหญ่ต่างก็ต้องการผลตอบแทน ซึ่งพวกเราเองก็ใช้ AI ในการทำงานทุกวัน แต่ตอนนี้เรากำลังถอยออกมาพิจารณาให้รอบคอบขึ้นอีกนิด
และนี่คือเหตุผล:
เราไม่อยากช่วยฝึกฝนโมเดลด้วยข้อมูลที่ละเอียดอ่อนของเรา
Slack แอบประกาศเงื่อนไขการให้บริการแบบเงียบๆ ว่าพวกเขาจะใช้ข้อมูลทั้งหมดของคุณเพื่อฝึกฝนโมเดล AI และปรับปรุงประสบการณ์การใช้งาน
ลองอ่านดูอีกทีนะครับ พวกเขาจะดึงบทสนทนาส่วนตัวของคุณเข้าสู่ระบบข้อมูลเพื่อฝึก AI และพวกเขาไม่ใช่เจ้าเดียวที่ทำแบบนี้! ทั้ง Figma, Adobe, Cursor, Slack และอีกหลายบริษัทต่างก็ฝึกโมเดลด้วยข้อมูลส่วนตัวหรือทรัพย์สินทางปัญญาของคุณทั้งนั้น
โมเดล AI ยังคงมีอาการหลอน (Hallucinate) และสร้างข้อผิดพลาดได้
ในการพัฒนาซอฟต์แวร์ เราต้องทำงานกับข้อมูลที่ละเอียดอ่อน ชุดข้อมูลขนาดใหญ่ สถาปัตยกรรมที่ซับซ้อน และรหัสผ่านที่เป็นความลับมากมาย เช่นเดียวกับที่คุณจะไม่ยอม Commit ตัว API key ลงบน GitHub คุณก็ไม่ควรให้เครื่องมือ AI อย่าง Cursor เข้าถึงฐานรหัส (Codebase) ทั้งหมดที่มีกุญแจสำคัญเหล่านี้อยู่
โค้ดทุกบรรทัด ไม่ว่าจะสร้างโดย AI หรือไม่ ควรผ่านการกลั่นกรองอย่างละเอียดจากสติปัญญาของมนุษย์ หากขาดกระบวนการตรวจสอบ ก็จะไม่มีใครรับผิดชอบเมื่อเกิดความผิดพลาดครั้งใหญ่ขึ้น
ความเรียบง่าย
บางอย่างไม่จำเป็นต้องใช้ AI ก็ทำได้อย่างมีประสิทธิภาพ หากคุณไม่สามารถสื่อสารข้อความให้เพื่อนร่วมงานเข้าใจได้อย่างชัดเจน การขอให้ LLM ทำแทนก็ถือว่าไม่มีประสิทธิภาพ เพราะความพยายามที่ต้องใช้ในการอธิบายข้อความให้ LLM เข้าใจนั้น ยากพอๆ กับการลงมือทำเองเลยทีเดียว
ในทางกลับกัน AI ควรเป็นเครื่องมือที่ช่วยปรับปรุงการสื่อสารโดยการให้คำแนะนำในทันที มากกว่าที่จะเป็นตัวกลางในการสื่อสารเสียเอง
การจ้างคนด้วยตัวเองนั้นใช้เวลามากก็จริง แต่ AI ก็ไม่ได้ช่วยให้ระบบ ATS ที่มีอยู่เดิมดีขึ้นเท่าไหร่นัก มันกลับเพิ่มความซับซ้อนให้กับเครื่องมือที่ทำหน้าที่เพียงแค่ตรวจหาคีย์เวิร์ดในเรซูเม่เพื่อจัดลำดับผู้สมัคร เพื่อให้ผู้จัดการฝ่ายบุคคลสัมภาษณ์ผู้สมัครกลุ่มท็อปๆ เท่านั้น
สรุปง่ายๆ คือ เราจะใช้เครื่องมือ AI ก็ต่อเมื่อเข้าเงื่อนไข 3 ข้อนี้:
ไม่ทำให้ข้อมูลที่ละเอียดอ่อนของเราตกอยู่ในความเสี่ยง
ผลลัพธ์สามารถปรับแต่งและตรวจสอบได้ด้วยคน
ช่วยให้กระบวนการทำงานของเราดีขึ้นจริงๆ
ที่ We Do Dev Work เรายึดถือแนวทางที่ให้ความสำคัญกับมนุษย์เป็นศูนย์กลางในการขับเคลื่อนการพัฒนาซอฟต์แวร์
เราสร้างซอฟต์แวร์ที่ชาญฉลาดและรองรับการขยายตัว เพื่อสร้างความเปลี่ยนแปลงที่สำคัญให้กับการดำเนินธุรกิจ
เรียนรู้เพิ่มเติมได้ที่: wedodevwork.com.
อ่านต่อ
คำถามที่พบบ่อย
ทำไม We Do Dev Work จึงระมัดระวังเรื่องเครื่องมือ AI
ไม่ต้องการช่วยฝึกโมเดลด้วยข้อมูลที่ละเอียดอ่อน และ AI ยังคงมีภาพหลอนและทำผิดพลาด บทความระบุว่าหลายเครื่องมือฝึกด้วยข้อมูลส่วนตัวหรือทรัพย์สินทางปัญญา
บริษัทใช้ AI บ้างหรือไม่
ใช้ ใช้ AI ทุกวันแต่ถอยออกมาหนึ่งก้าว ใช้เฉพาะเมื่อไม่กระทบข้อมูลที่ละเอียดอ่อน ผลลัพธ์ตรวจและแก้ไขด้วยมือได้ และช่วยให้กระบวนการดีขึ้น
ทำไมจึงไม่ให้เครื่องมือ AI เข้าถึงโค้ดเบสทั้งหมด
โค้ดเบสมีข้อมูลที่ละเอียดอ่อนและข้อมูลรับรองลับ เหมือนที่คุณไม่ commit API key ขึ้น GitHub คุณก็ไม่ควรให้เครื่องมือ AI เข้าถึงสิ่งเหล่านั้น
ควรตรวจโค้ดที่ AI สร้างหรือไม่
ควร บทความระบุว่าโค้ดทุกบรรทัด ไม่ว่า AI จะสร้างหรือไม่ ควรผ่านการคิดอย่างรอบคอบโดยมนุษย์ที่มีวิจารณญาณ ไม่เช่นนั้นจะไม่มีใครรับผิดชอบ
บทความที่เกี่ยวข้อง
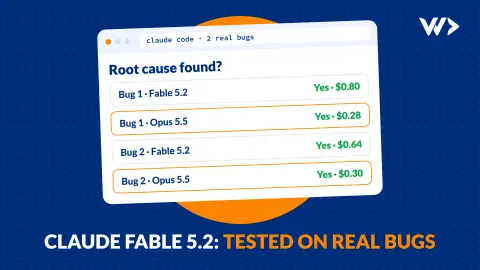
ทดสอบ Claude Fable 5.2 กับบั๊กจริง 2 ตัว: คุ้มค่าไหม?
Claude Fable 5.2 เปิดตัว 9 พฤศจิกายน 2569 เราให้มันและ Opus 5.5 แก้บั๊กจริง 2 ตัวจากเว็บไซต์ของเราเอง ทั้งคู่หาสาเหตุเจอ แต่ Opus ใช้ต้นทุนไม่ถึงครึ่ง

เชื่อมต่อซอฟต์แวร์ของคุณกับ Claude หรือ ChatGPT: MCP Server ต้องใช้อะไรบ้าง?
MCP Server ช่วยให้ Claude หรือ ChatGPT สามารถอ่านและแก้ไขข้อมูลในซอฟต์แวร์ของคุณได้ เราใช้เวลาเพียงหนึ่งวันในการสร้าง MCP Server สำหรับระบบจัดการโปรเจกต์ของเรา และมีการดำเนินการถึง 1,338 ครั้งภายใน 10 วันแรก มาดูกันว่าระบบนี้ทำงานอย่างไร และมีอะไรบ้างที่ต้องเตรียมให้พร้อม
LLM กับโมเดล System One: Claude และ ChatGPT เทียบกับ Jev และ SubQ Snap
LLM อย่าง Claude และ ChatGPT เขียนคำตอบ ส่วนโมเดลตัดสินใจ System One อย่าง Jev และ SubQ Snap เลือกคำตอบ ความแตกต่าง ราคา และเมื่อไรควรใช้แบบไหน