พื้นฐาน AI สำหรับธุรกิจ: อธิบาย LLM, RAG, Agent และ Fine-Tuning

ที่ We Do Dev Workเราไม่ได้แค่ใช้ AI (เขียนบทความบล็อก) แต่เราสร้างงานด้วย AI ทุกวัน อย่างไรก็ตาม ศัพท์แสงในวงการมีมากมายเต็มไปด้วยคำฮิต จนแยกยากว่าคำไหนสำคัญต่อธุรกิจ คู่มือนี้เหมาะสำหรับผู้ก่อตั้ง ผู้จัดการผลิตภัณฑ์ นักพัฒนา และผู้ที่อยากรู้ ที่ต้องการเข้าใจส่วนประกอบจริงของระบบ AI สมัยใหม่ และควรเริ่มจากอะไรก่อน
ถ้าอยากได้สรุปแบบย่อหน้าเดียว: งาน AI ทางธุรกิจส่วนใหญ่ในปัจจุบันคือการนำโมเดลภาษาที่มีอยู่แล้วมาป้อนข้อมูลของคุณให้ (RAG) และบางครั้งให้มันลงมือทำสิ่งต่าง ๆ ได้ (agent) ส่วนการฝึกโมเดลใหม่ (fine-tuning) เป็นข้อยกเว้น ไม่ใช่จุดเริ่มต้น
คำศัพท์สำคัญโดยสรุป
| คำศัพท์ | ความหมายแบบเข้าใจง่าย | เหมาะกับ | ข้อควรระวัง |
|---|---|---|---|
| Machine learning | ซอฟต์แวร์ที่เรียนรู้รูปแบบจากข้อมูล แทนที่จะทำตามกฎที่คนเขียนไว้ | การพยากรณ์และการจัดประเภท: คาดการณ์ความต้องการ ตรวจจับการฉ้อโกง คัดแยกทิกเก็ต | ต้องใช้ข้อมูลที่ดีและเกี่ยวข้อง ผลลัพธ์เป็นความน่าจะเป็น ไม่ใช่การรับประกัน |
| LLM (large language model) | โมเดล machine learning ที่ฝึกด้วยข้อความจำนวนมหาศาล สามารถอ่านและเขียนภาษาได้ | ร่างเนื้อหา สรุป ตอบคำถาม ดึงข้อมูลจากข้อความที่ไม่เป็นระเบียบ | อาจพูดสิ่งที่ผิดอย่างมั่นใจ และรู้เพียงสิ่งที่ถูกฝึกมาบวกกับสิ่งที่คุณให้ |
| Prompt engineering | การเขียนคำสั่งและตัวอย่างที่ชัดเจนเพื่อให้โมเดลให้ผลลัพธ์ที่เป็นประโยชน์ | ก้าวแรกที่ถูกที่สุด มักเพียงพอสำหรับงานง่าย ๆ | ผลลัพธ์อาจแปรผัน ควรทดสอบ prompt กับตัวอย่างจริง ไม่ใช่ลองครั้งเดียวที่บังเอิญได้ผลดี |
| Embeddings และ vector database | ข้อความที่ถูกแปลงเป็นตัวเลขซึ่งสื่อความหมาย และจัดเก็บไว้เพื่อให้ค้นหาด้วยความหมายได้ ไม่ใช่แค่คำที่ตรงกันเป๊ะ | ค้นหาในเอกสารของคุณเอง หารายการที่คล้ายกัน ระบบแนะนำ | คุณภาพการค้นหาขึ้นอยู่กับวิธีแบ่งเอกสารและการอัปเดตให้ทันสมัยอยู่เสมอ |
| RAG (retrieval-augmented generation) | ค้นหาข้อความที่เกี่ยวข้องจากเอกสารของคุณก่อน แล้วส่งให้ LLM ใช้ตอบ | บอตซัพพอร์ต การค้นหาความรู้ภายในองค์กร คำตอบที่ต้องเป็นไปตามนโยบายของคุณ | ถ้าหาเอกสารที่ถูกต้องไม่เจอ คำตอบก็จะไม่ดี ต้องมีเนื้อหาต้นทางที่เป็นระเบียบ |
| AI agent | ระบบที่ LLM ตัดสินใจเลือกขั้นตอนและใช้เครื่องมือ (ค้นหา ปฏิทิน ฐานข้อมูล อีเมล) เพื่อให้บรรลุเป้าหมาย | งานหลายขั้นตอน: คัดแยกคำขอ เตรียมรายงาน อัปเดตระเบียน | มีส่วนประกอบเคลื่อนไหวมากขึ้น จึงมีโอกาสพลาดมากขึ้น ควรให้คนอนุมัติทุกอย่างที่มีความเสี่ยง |
| Fine-tuning | การฝึกโมเดลพื้นฐานเพิ่มเติมด้วยตัวอย่างของคุณเอง เพื่อเปลี่ยนวิธีที่มันตอบสนอง | น้ำเสียงหรือรูปแบบผลลัพธ์ที่สม่ำเสมอ หรืองานเฉพาะทางที่ทำในปริมาณมาก | ต้องใช้ข้อมูลฝึกที่มีคุณภาพและความพยายาม และผลลัพธ์จะหยุดนิ่งจนกว่าจะฝึกใหม่ |
| Multimodal AI | โมเดลที่จัดการรูปภาพ เสียง หรือวิดีโอได้ นอกเหนือจากข้อความ | อ่านใบแจ้งหนี้และภาพหน้าจอ ถอดเสียงการโทร อธิบายภาพสินค้า | ตรวจสอบความแม่นยำกับไฟล์ของคุณเอง ไม่ใช่กับตัวอย่างสาธิต |
Machine learning ร่มใหญ่ของทุกอย่าง
Machine learning คือสาขากว้าง โมเดลเรียนรู้จากตัวอย่างแล้วนำสิ่งที่เรียนรู้ไปใช้กับข้อมูลใหม่ ตัวกรองสแปม การพยากรณ์ความต้องการ และรายการแนะนำ ล้วนเป็น machine learning และมีมานานก่อนแชตบอต เมื่อมีคนพูดว่า "AI" ในที่ประชุมธุรกิจ ลองถามว่าหมายถึงแบบเก่า (ทำนายตัวเลขหรือป้ายกำกับจากข้อมูลของคุณ) หรือแบบใหม่ที่เป็นโมเดลภาษา (สร้างข้อความ) ทั้งสองแก้ปัญหาต่างกันและต้องใช้ข้อมูลต่างกัน
Large Language Models (LLM)
LLM คือเครื่องยนต์เบื้องหลังเครื่องมืออย่าง ChatGPT, Claude และ Gemini รวมถึงโมเดลโอเพนซอร์สอย่าง Llama, Mistral และ DeepSeek ถูกฝึกด้วยข้อความจำนวนมหาศาลเพื่อสร้างภาษาที่เหมือนมนุษย์
ตัวอย่างการใช้งาน: ช่วยเขียน สรุปรายงาน ตอบคำถามลูกค้า
ลองนึกถึง LLM เป็นสมองอเนกประสงค์ที่ตอบและสร้างข้อความได้จากรูปแบบที่มันเรียนรู้มา
ความหมายสำหรับธุรกิจ: LLM เก่งมากเรื่องงานด้านภาษา แต่เชื่อถือเป็นแหล่งความจริงไม่ได้ มันไม่รู้ราคา สัญญา หรือการตัดสินใจเมื่อสัปดาห์ที่แล้วของคุณ หากคุณไม่ป้อนให้ ช่องว่างนั้นคือสิ่งที่ส่วนถัดไปจะตอบ
Prompt Engineering
Prompt engineering คือการออกแบบอินพุตเพื่อให้ได้ผลลัพธ์ที่ดีขึ้นจาก LLM ซึ่งส่งผลต่อผลลัพธ์อย่างมาก และแทบไม่มีค่าใช้จ่ายในการลอง
ตัวอย่างการใช้งาน: เปลี่ยน prompt ที่คลุมเครืออย่าง "เขียนเรื่องการตลาด" เป็น "เขียนสรุป 3 ย่อหน้าเกี่ยวกับเทรนด์การตลาด B2B สมัยใหม่ด้วยภาษาโน้มน้าวใจ"
Prompt ที่ยอดเยี่ยม = ผลลัพธ์ที่ยอดเยี่ยม Prompt ที่พอใช้ = ผลลัพธ์ที่ไม่แน่นอน
Embeddings และ Vector Database
Embedding แปลงข้อความเป็นเวกเตอร์ (รายการตัวเลข) ที่แทนความหมายของข้อความนั้น ทำให้คอมพิวเตอร์เปรียบเทียบความหมายได้ ไม่ใช่แค่คำที่ตรงกันเป๊ะ เมื่อมี embedding แล้วก็ต้องมีที่เก็บและสอบถามข้อมูล ซึ่งเป็นที่มาของ vector database อย่าง Pinecone, Weaviate หรือ pgvector (ที่ใช้ใน Supabase ที่เรารัก)
ตัวอย่างการใช้งาน: ค้นหาเอกสารที่คล้ายกันในฐานความรู้ แม้จะใช้คำต่างกัน เพื่อให้แชตบอตของคุณหาเอกสารภายในที่ถูกต้องเจอ
Embedding และ vector DB ทำให้แอป AI "รู้จัก" ข้อมูลเฉพาะของคุณ
Retrieval-Augmented Generation (RAG)
RAG คือเทคนิคที่ดึงเอกสารที่เกี่ยวข้องด้วย embedding แล้วส่งให้ LLM ก่อนที่มันจะสร้างคำตอบ โมเดลจะตอบจากเนื้อหาของคุณแทนที่จะตอบจากความจำ และคุณสามารถแสดงได้ว่าคำตอบมาจากเอกสารใด
ตัวอย่างการใช้งาน: แชตบอตซัพพอร์ตลูกค้าที่ดึงนโยบายจากคู่มือพนักงานของบริษัทก่อนตอบ
RAG มักยืดหยุ่นและถูกกว่า fine-tuning เพราะการอัปเดตคำตอบแค่แก้เอกสาร ไม่ต้องฝึกโมเดลใหม่
AI Agent
Agent คือระบบที่ใช้ LLM เพื่อลงมือทำสิ่งต่าง ๆ ต่างจากแชตบอตที่ทำได้แค่ตอบ agent สามารถให้เหตุผลเกี่ยวกับเป้าหมาย จำบริบท เรียกใช้เครื่องมือ และเชื่อมหลายขั้นตอนเข้าด้วยกัน
ตัวอย่างการใช้งาน: ผู้ช่วยเสมือนที่จัดตารางสัปดาห์ของคุณโดยอ่านปฏิทิน จองการเดินทาง และส่งการแจ้งเตือน
Agent ไม่ใช่แค่แชต แต่ทำสิ่งต่าง ๆ ได้จากผลลัพธ์ของ LLM
ยิ่ง agent ทำได้มาก ยิ่งต้องระมัดระวังมาก ควรให้สิทธิ์แคบที่สุดเท่าที่ใช้งานได้ บันทึกสิ่งที่มันทำ และให้คนเข้ามาร่วมตัดสินใจในทุกอย่างที่เกี่ยวกับการใช้เงิน การลบข้อมูล หรือการติดต่อลูกค้า
Fine-Tuning
Fine-tuning คือการนำ LLM พื้นฐานมาฝึกเพิ่มด้วยตัวอย่างของคุณเอง สร้างโมเดลเวอร์ชันใหม่ที่เฉพาะกับการใช้งานของคุณ เช่น โมเดลที่เขียนด้วยน้ำเสียงของแบรนด์คุณอย่างสม่ำเสมอ
ตัวอย่างการใช้งาน: โมเดลที่ฝึกด้วยคำตอบซัพพอร์ตในอดีตของคุณ เพื่อให้ตอบด้วยสไตล์และรูปแบบของบริษัท
Fine-tuning ทรงพลังแต่ใช้ทรัพยากรมากและไม่ยืดหยุ่น
ความผิดพลาดที่พบบ่อยคือการ fine-tune เพื่อสอนข้อเท็จจริงให้โมเดล ข้อเท็จจริงเปลี่ยนแปลงได้ และโมเดลที่ fine-tune แล้วจะไม่รู้จนกว่าจะฝึกใหม่ ใช้ RAG สำหรับความรู้ และเก็บ fine-tuning ไว้สำหรับพฤติกรรมและสไตล์
Multimodal AI
ระบบ AI บางตัวจัดการได้ไม่ใช่แค่ข้อความ แต่รวมถึงรูปภาพ เสียง และวิดีโอ: เสียงเป็นข้อความ ข้อความเป็นรูปภาพ การอ่านภาพหน้าจอหรือใบแจ้งหนี้ที่สแกน
ตัวอย่างการใช้งาน: AI ที่วิเคราะห์ภาพหน้าจอ ถอดเสียง หรือดึงรายการสินค้าจากภาพถ่ายใบเสร็จ
โอเพนซอร์ส vs โมเดลแบบปิด
โมเดลแบบ open-weight (เช่น Llama, Mistral และ DeepSeek) ดาวน์โหลดมาโฮสต์เองและปรับแต่งได้ โมเดลแบบปิด (เช่นของ OpenAI, Anthropic และ Google) ใช้ผ่าน API และแก้ไขไม่ได้ แม้หลายตัวปรับแต่งได้ผ่าน prompt และในบางกรณีผ่าน fine-tuning ของผู้ให้บริการ
ตัวอย่างการใช้งาน: โฮสต์โมเดลเองเมื่อข้อมูลต้องอยู่บนเซิร์ฟเวอร์ของคุณ เทียบกับการเรียก API เมื่อต้องการโมเดลที่แข็งแกร่งที่สุดโดยตั้งค่าน้อยที่สุด
โอเพน = ควบคุมและยืดหยุ่นได้ แต่คุณต้องรันเอง ปิด = สะดวกและทรงความสามารถ แต่คุณต้องพึ่งผู้ให้บริการ
โปรดทราบว่า "ต้นทุนต่ำกว่า" ไม่ได้เกิดขึ้นเองกับโมเดลโอเพน: คุณต้องจ่ายค่าเซิร์ฟเวอร์และคนที่ดูแลมัน เราพูดถึงต้นทุนการรันจริงใน ต้นทุนไม่ใช่ศูนย์
ต้องใช้แบบไหน? หลักการคร่าว ๆ
- คำตอบจากเอกสารของคุณ: เริ่มด้วย RAG
- ทำนายหรือจัดประเภทจากตัวเลขของคุณเอง (การเลิกใช้บริการ ความต้องการ การฉ้อโกง): machine learning แบบดั้งเดิม ไม่ใช่ LLM
- ร่างเนื้อหา สรุป ดึงข้อมูลจากข้อความ: LLM พร้อม prompt ที่ดี ไม่ต้องใช้เทคโนโลยีเพิ่ม
- งานที่คาบเกี่ยวหลายระบบและหลายขั้นตอน: agent พร้อมการอนุมัติโดยมนุษย์ในขั้นตอนที่เสี่ยง
- น้ำเสียง รูปแบบ หรืองานเฉพาะทางปริมาณมากที่สม่ำเสมอ: พิจารณา fine-tuning หลังจาก prompt และ RAG ยังไม่พอ
- ข้อมูลอ่อนไหวที่ออกนอกโครงสร้างพื้นฐานของคุณไม่ได้: ดูโมเดลโอเพนที่คุณโฮสต์เอง หรือเงื่อนไขของผู้ให้บริการที่ตรงกับข้อกำหนดด้านการปฏิบัติตามกฎระเบียบของคุณ
เริ่มต้นอย่างไร
- เลือกปัญหาที่เป็นรูปธรรมหนึ่งเรื่อง เรื่องที่ซ้ำซาก เกี่ยวกับข้อความมาก และน่าปวดหัว เช่น การตอบคำถามซัพพอร์ตเดิม ๆ หรือการสรุปเอกสารยาว ๆ หลีกเลี่ยงแนวคิด "ใส่ AI ในทุกอย่าง"
- ตรวจสอบข้อมูลของคุณ เอกสารเป็นปัจจุบัน หาเจอ และได้รับอนุญาตให้ใช้หรือไม่? แหล่งข้อมูลที่รกจะให้คำตอบที่รก
- ทำต้นแบบด้วยโมเดลที่มีอยู่และ prompt ลองกับตัวอย่างจริงจากงานของคุณ รวมถึงกรณีที่ยุ่งยากด้วย
- เพิ่ม RAG หากต้องใช้ความรู้ของคุณแล้วค่อยเพิ่ม agent เฉพาะเมื่อต้องลงมือทำ ส่วน fine-tune ไว้ท้ายสุด
- วัดผลเทียบกับเกณฑ์พื้นฐาน เปรียบเทียบคุณภาพและเวลาที่ประหยัดได้กับวิธีทำงานในปัจจุบัน และให้คนตรวจสอบผลลัพธ์ในช่วงแรก
- วางแผนเรื่องต้นทุนการรันและความเสี่ยง: ค่าใช้งาน การเฝ้าระวัง และสิ่งที่จะเกิดขึ้นเมื่อโมเดลตอบผิด ดู ต้นทุนไม่ใช่ศูนย์
สำหรับภาพรวมที่กว้างขึ้น อ่าน การพัฒนา AI คืออะไร? และ AI เปลี่ยนการพัฒนาซอฟต์แวร์อย่างไรหากต้องการความช่วยเหลือในการกำหนดขอบเขตโปรเจกต์แรก ดู บริการพัฒนา AI ของเรา หรือ ราคา
ความคิดส่งท้าย
การเข้าใจแนวคิดเหล่านี้ช่วยให้คุณมอง AI ไม่ใช่เวทมนตร์ แต่เป็นกล่องเครื่องมือ กล่องเครื่องมือที่ช่วยให้คุณออกแบบวิศวกรรมทางออกที่ดีขึ้นให้บริษัทหรือลูกค้าของคุณ อนาคตเป็นของผู้ที่ประกอบชิ้นส่วนเหล่านี้เข้าด้วยกันได้ โดยเริ่มจากเล็ก ๆ และวัดผลอย่างซื่อตรง
อยากสร้างด้วยเทคโนโลยีนี้ไหม? คุยกัน ที่ We Do Dev Workเราช่วยบริษัทเปลี่ยนเครื่องมือ AI ให้เป็นทางออกที่ใช้งานได้จริงและขยายขนาดได้
ไม่ใช่ทุกงาน AI ที่ต้องใช้โมเดลภาษาขนาดใหญ่ สำหรับการตัดสินใจที่รวดเร็วและมีโครงสร้าง เช่น การกำหนดเส้นทางหรือการให้คะแนน อ่าน LLM vs โมเดล System One
คำถามที่พบบ่อย
Machine learning กับ LLM ต่างกันอย่างไร?
Machine learning คือสาขากว้างของซอฟต์แวร์ที่เรียนรู้จากข้อมูล ส่วน LLM เป็นโมเดล machine learning ชนิดหนึ่งที่ฝึกด้วยข้อความเพื่ออ่านและเขียนภาษา
RAG คืออะไร อธิบายแบบง่าย ๆ
RAG ค้นหาข้อความที่เกี่ยวข้องจากเอกสารของคุณเองก่อน แล้วส่งให้ LLM เพื่อให้ตอบจากเนื้อหาของคุณ ไม่ใช่จากความจำ
ควรใช้ RAG หรือ fine-tuning?
ใช้ RAG เมื่อโมเดลต้องใช้ความรู้ของคุณ เพราะการอัปเดตเอกสารง่ายกว่าการฝึกใหม่ พิจารณา fine-tuning เฉพาะเมื่อต้องการสไตล์ รูปแบบ หรืองานเฉพาะทางที่สม่ำเสมอ
AI agent คืออะไร และต่างจากแชตบอตอย่างไร?
แชตบอตตอบกลับเป็นข้อความ ส่วน agent ใช้ LLM วางแผนขั้นตอนและเรียกใช้เครื่องมือ เช่น ปฏิทินหรือฐานข้อมูล เพื่อทำงานให้สำเร็จ
ต้องมีโมเดลของตัวเองเพื่อใช้ AI ในธุรกิจหรือไม่?
โดยปกติไม่ต้อง การใช้งานทางธุรกิจส่วนใหญ่เริ่มจากโมเดลที่มีอยู่ผ่าน API แล้วเพิ่มข้อมูลของคุณด้วย RAG การโฮสต์โมเดลโอเพนสำคัญเป็นหลักเมื่อต้องควบคุมข้อมูลอย่างเข้มงวด
จะเริ่มใช้ AI ในบริษัทได้อย่างไร?
เลือกปัญหาที่ซ้ำซากและเกี่ยวกับข้อความมากหนึ่งเรื่อง ตรวจสอบข้อมูล ทำต้นแบบด้วยโมเดลที่มีอยู่ และวัดผลเทียบกับวิธีทำงานในปัจจุบัน
บทความที่เกี่ยวข้อง
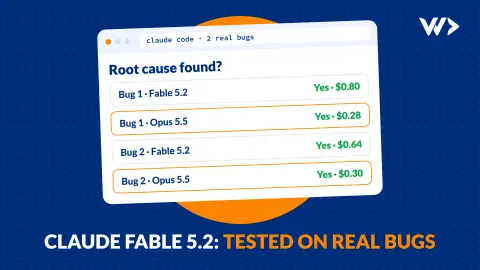
ทดสอบ Claude Fable 5.2 กับบั๊กจริง 2 ตัว: คุ้มค่าไหม?
Claude Fable 5.2 เปิดตัว 9 พฤศจิกายน 2569 เราให้มันและ Opus 5.5 แก้บั๊กจริง 2 ตัวจากเว็บไซต์ของเราเอง ทั้งคู่หาสาเหตุเจอ แต่ Opus ใช้ต้นทุนไม่ถึงครึ่ง

เชื่อมต่อซอฟต์แวร์ของคุณกับ Claude หรือ ChatGPT: MCP Server ต้องใช้อะไรบ้าง?
MCP Server ช่วยให้ Claude หรือ ChatGPT สามารถอ่านและแก้ไขข้อมูลในซอฟต์แวร์ของคุณได้ เราใช้เวลาเพียงหนึ่งวันในการสร้าง MCP Server สำหรับระบบจัดการโปรเจกต์ของเรา และมีการดำเนินการถึง 1,338 ครั้งภายใน 10 วันแรก มาดูกันว่าระบบนี้ทำงานอย่างไร และมีอะไรบ้างที่ต้องเตรียมให้พร้อม
LLM กับโมเดล System One: Claude และ ChatGPT เทียบกับ Jev และ SubQ Snap
LLM อย่าง Claude และ ChatGPT เขียนคำตอบ ส่วนโมเดลตัดสินใจ System One อย่าง Jev และ SubQ Snap เลือกคำตอบ ความแตกต่าง ราคา และเมื่อไรควรใช้แบบไหน