หลีกเลี่ยงข้อผิดพลาดที่พบบ่อยในการพัฒนาซอฟต์แวร์ (พร้อมเคสกู้โปรเจกต์จริง)
การพัฒนาซอฟต์แวร์เป็นเรื่องน่าตื่นเต้น แต่ก็เป็นการลงทุนจริงจัง ที่มีคนหลายฝ่ายเข้ามาเกี่ยวข้องและมีบทบาทของตัวเอง แม้แต่ทีมที่มีประสบการณ์ก็ยังพลาดในกับดักเดิม ๆ และกับดักเหล่านี้ทำให้งานล่าช้า งบบานปลาย และในกรณีที่แย่ที่สุด ได้ผลิตภัณฑ์ที่ไม่มีใครเชื่อถืออีกต่อไป
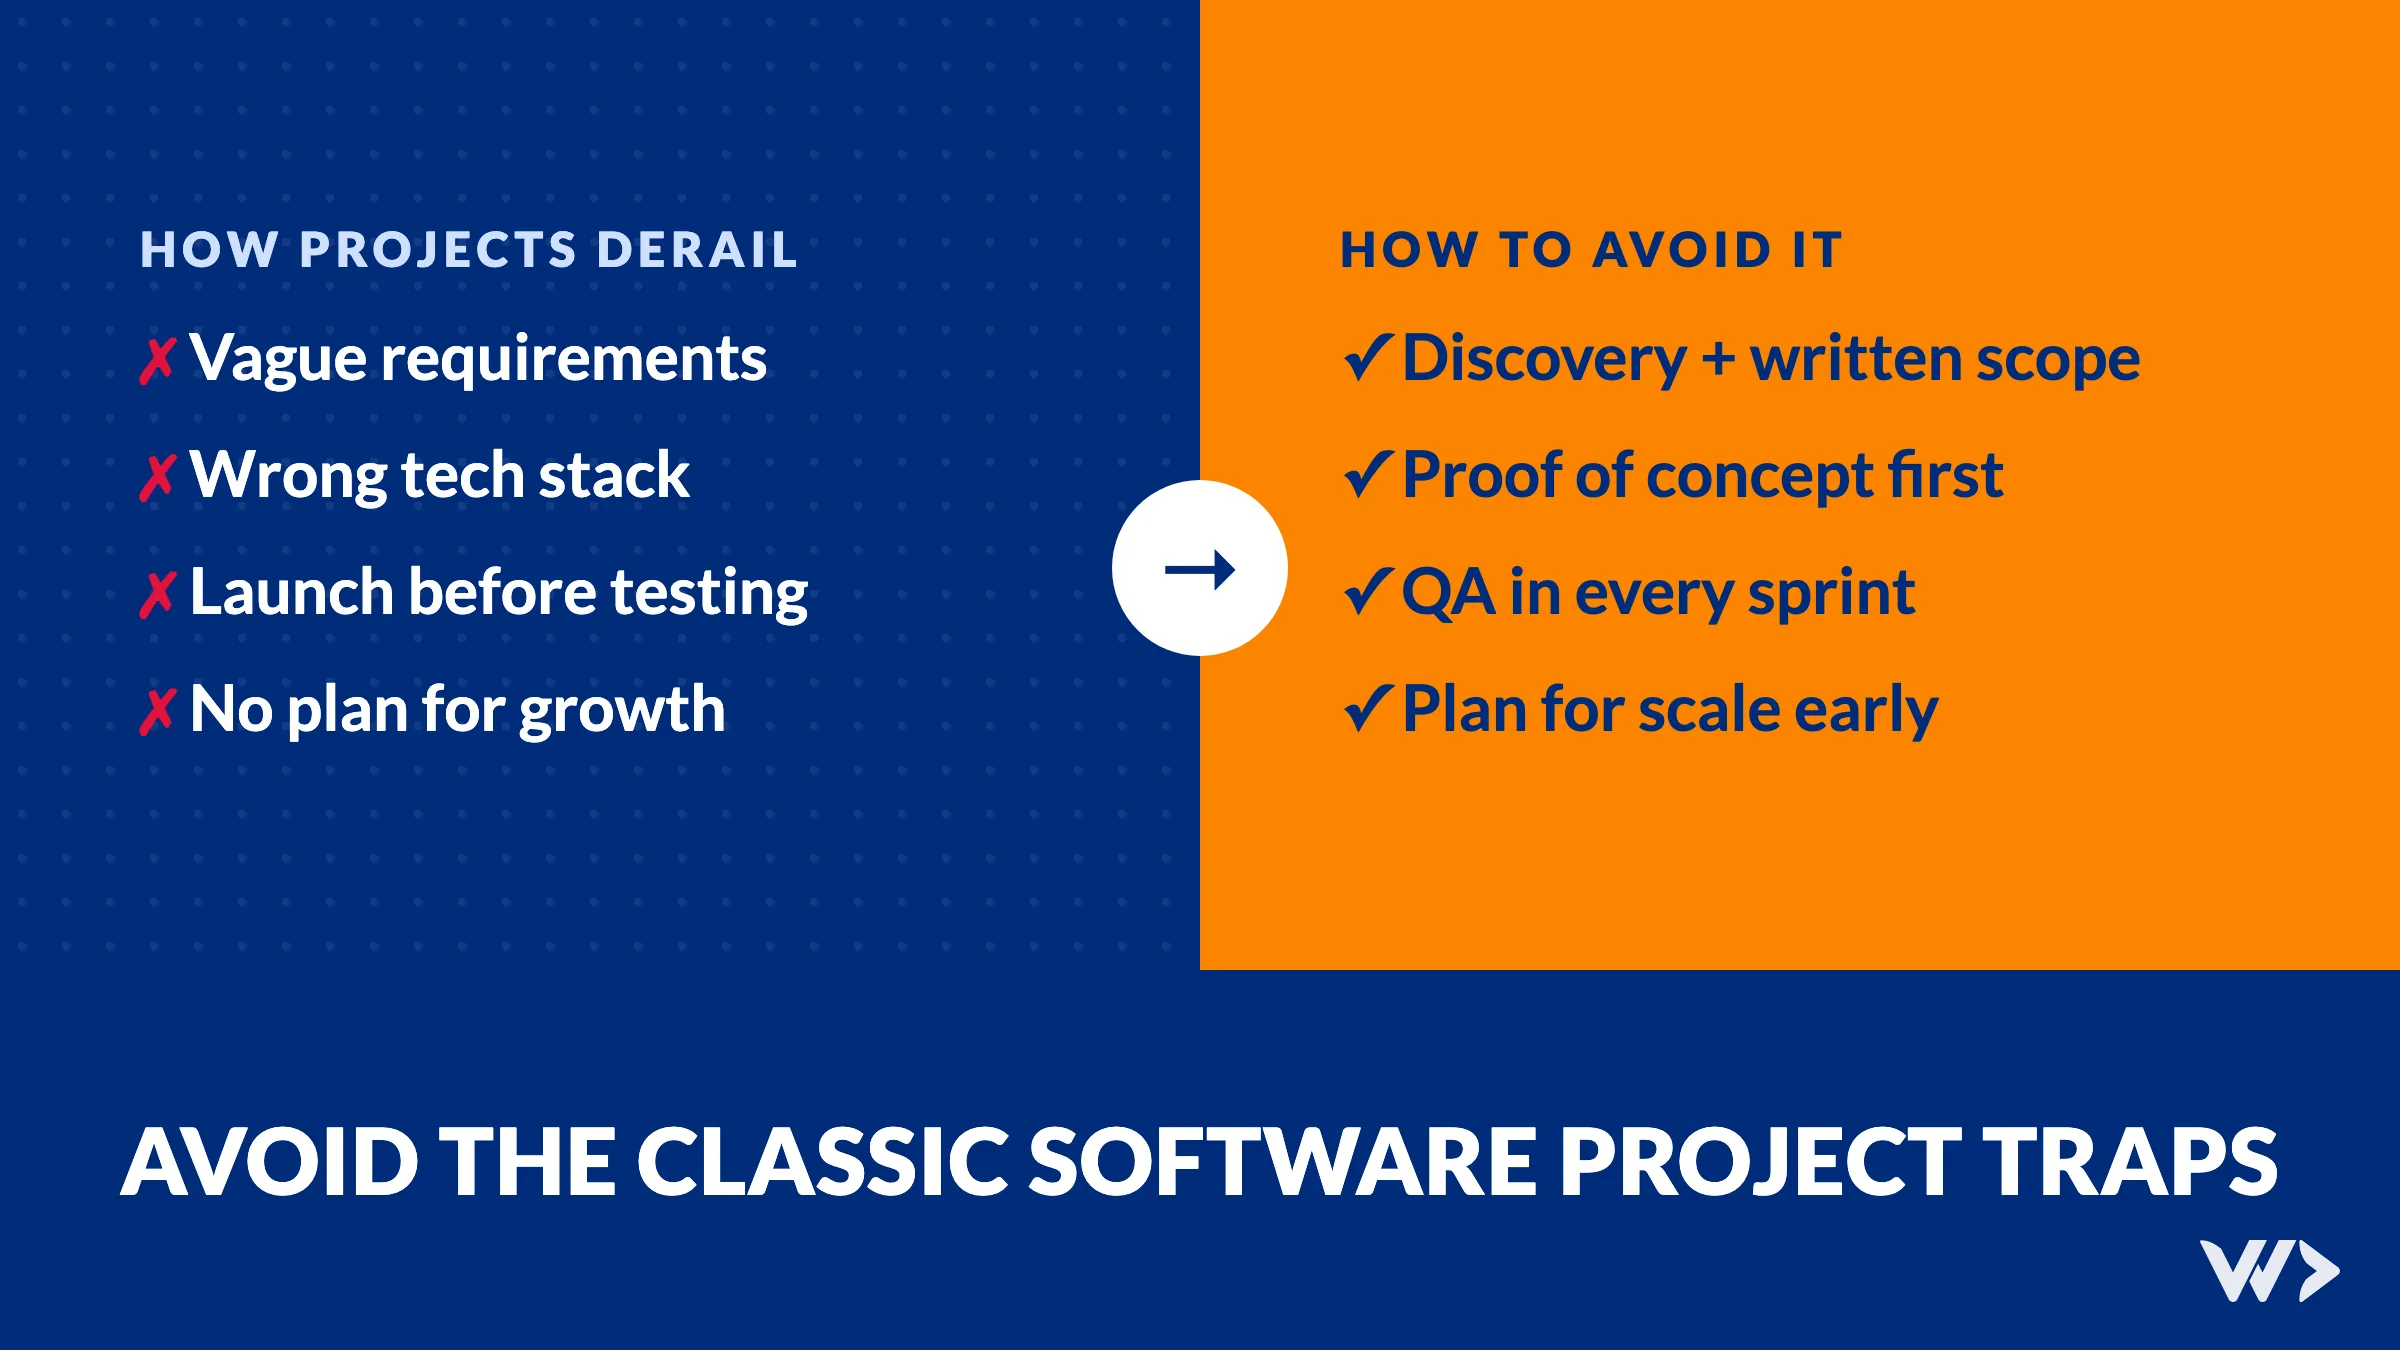
คำตอบสั้น ๆ: โปรเจกต์ส่วนใหญ่ที่พังมักพลาดใน 4 เรื่อง คือ รากฐานไม่แน่น เลือก tech stack ผิด เปิดตัวก่อนทดสอบ และไม่คิดว่าจะเกิดอะไรขึ้นเมื่อผลิตภัณฑ์ประสบความสำเร็จ ด้านล่างเราจะไล่ดูทีละเรื่อง พร้อมเคสจริงจากงานของเราเอง และปิดท้ายด้วยเช็กลิสต์ที่ใช้ได้ก่อนเริ่มโปรเจกต์ถัดไป ไม่ว่าคุณจะเป็นเจ้าของธุรกิจ ผู้จัดการโปรเจกต์ หรือวิศวกร การตัดสินใจของคุณมีผลทั้งนั้น
สรุป 4 กับดักแบบเห็นภาพรวม
| กับดัก | สิ่งที่คุณจะสังเกตเห็น | วิธีหลีกเลี่ยง |
|---|---|---|
| รากฐานไม่แน่น | Scope creep แก้งานไม่จบ พลาดกำหนดส่ง | ช่วง discovery, scope ที่เขียนไว้ชัด, backlog ที่จัดลำดับความสำคัญ |
| เลือก tech stack ผิด | งานเดินช้า บั๊กแปลก ๆ ต้องเขียนใหม่ด้วยต้นทุนสูง | ใช้ stack ที่ทีมถนัด ทำ proof of concept ก่อน |
| เปิดตัวก่อนทดสอบ | บั๊กร้ายแรงทันทีหลัง go-live ผู้ใช้หมดความเชื่อมั่น | QA ในทุก sprint, user acceptance testing, ปล่อยเป็นระยะ |
| ละเลยการขยายระบบ | แอปช้า ค่า cloud พุ่ง ความเสี่ยงด้านความปลอดภัยเพิ่มเมื่อโตขึ้น | วางแผนรองรับการเติบโตตั้งแต่ต้น ทำตามแนวปฏิบัติทางวิศวกรรมที่ดี |

1. รากฐานโปรเจกต์ไม่แน่น
หัวใจของทุกโปรเจกต์คือไอเดีย ฟีเจอร์ที่แก้ปัญหาซึ่งบางคนยังไม่รู้ด้วยซ้ำว่าตัวเองมี ตอนวางรากฐาน เราจะรวบรวม requirement แล้วแปลงเป็นรายการฟีเจอร์สั้น ๆ ที่สนับสนุนไอเดียหลักนั้น
ถ้าเข้าใจ requirement ผิด จะเกิด scope creep และงานแก้ซ้ำ งานที่ดูเหมือนใช้แค่ไม่กี่สัปดาห์กลายเป็นสนามรบของการตัดสินใจยาก ๆ คุณภาพลดลงเพื่อให้ทันกำหนด หนี้ทางเทคนิคพอกพูน ทีมหมดไฟ และผู้ใช้ได้ผลิตภัณฑ์ที่ช้าและเต็มไปด้วยบั๊ก
วิธีหลีกเลี่ยง: ศึกษาให้ดีในช่วง discovery ตรวจดีไซน์และแผนกับผู้มีส่วนได้ส่วนเสีย เขียน scope ให้จบในหน้าเดียว และบันทึกการตัดสินใจไว้ เพื่อลดเรื่องที่ต้องเถียงกันทีหลัง
- ในฐานะผู้มีส่วนได้ส่วนเสีย: มีส่วนร่วมต่อเนื่อง ตัดสินใจว่าอะไรต้องมาก่อน ขออัปเดตสม่ำเสมอ และให้ฟีดแบ็กเร็ว
- ในฐานะผู้จัดการโปรเจกต์: กำหนดขอบเขตให้ชัดและตั้งกำหนดส่งที่เป็นไปได้จริง ยึดตามนั้น และรักษาความเชื่อมั่นของลูกค้าด้วยการสื่อสารอย่างเปิดเผย

2. เลือก tech stack ผิด
เมื่อมีแผนแล้ว software architect จะเลือกภาษา framework, API ภายนอก, เครื่องมือทดสอบ และโฮสติ้ง stack ที่ดีต้องไม่ใหญ่เกินหรือเล็กเกินไป ยืดหยุ่นพอสำหรับการเปลี่ยนแปลงที่ต้องมาแน่ ๆ และมีของพร้อมใช้มากพอที่จะส่งงานได้ทันเวลา
มี 3 ข้อผิดพลาดที่เราเห็นซ้ำแล้วซ้ำเล่า:
- เครื่องมือแบบปิด บางแพลตฟอร์มทำให้สร้างได้เร็วโดยไม่ต้องเขียนโค้ดมาก จนกระทั่งเจอ requirement แรกที่แพลตฟอร์มไม่รองรับ หลังจากนั้นทุกการเปลี่ยนแปลงกลายเป็นการหาทางอ้อม
- stack ที่ทีมไม่คุ้นเคย ต้องหาวิธีทำใหม่ทุกฟีเจอร์ทำให้ทุกอย่างช้าลง และความไม่มีประสบการณ์ทำให้บั๊กหลุดผ่าน code review
- การสนับสนุนที่อ่อนแอ framework ที่อัปเดตน้อย เอกสารบาง หรือหานักพัฒนายาก จะดูแลรักษายากและแพง
วิธีหลีกเลี่ยง: ชั่งน้ำหนักเรื่อง vendor lock-in ระยะเวลาเรียนรู้ ความปลอดภัย และการดูแลระยะยาว และถามว่าผลิตภัณฑ์จะรับมือกับผู้ใช้ที่มากขึ้นหลายเท่าได้อย่างไร ทำ proof of concept เล็ก ๆ ก่อนตัดสินใจเดินแผนยาว
- ในฐานะผู้มีส่วนได้ส่วนเสีย: อย่าบังคับ stack ให้ทีม ตัดสินใจร่วมกัน หรือเลือกทีมที่มีประสบการณ์กับเทคโนโลยีที่คุณต้องการอยู่แล้ว
- ในฐานะผู้จัดการโปรเจกต์: อธิบายสถาปัตยกรรมให้ผู้เกี่ยวข้องทุกคนเข้าใจ และจัดคนที่ส่งงานด้วย stack นั้นได้อย่างมั่นใจเข้าโปรเจกต์
3. เปิดตัวก่อนทดสอบ
เมื่อถูกกดดันด้วยกำหนดส่ง บางทีมประกาศว่าพร้อม go-live แล้ว แต่กลับเจอปัญหาร้ายแรงหลังเปิดตัว ปัญหาเหล่านั้นกลายเป็นงานด่วนที่สุดทันที แก้แพงกว่า และทำให้ผู้ใช้ประทับใจแรกในทางที่ไม่ดี
บั๊กที่แย่ที่สุดไม่ใช่บั๊กที่ทำให้แอปค้าง แต่เป็นบั๊กที่แสดงข้อมูลผิดแบบเงียบ ๆ คนเลิกเชื่อระบบ กลับไปใช้สเปรดชีตของตัวเอง และเงินที่ลงทุนไปก็ค่อย ๆ หมดคุณค่า
วิธีหลีกเลี่ยง: ให้การทดสอบเป็นส่วนหนึ่งของทุก sprint ไม่ใช่ช่วงท้ายโปรเจกต์ ทดสอบในมากกว่าหนึ่งสภาพแวดล้อม ทำ user acceptance testing กับผู้ใช้จริง และปล่อยเป็นระยะ ทำ automated test ให้โมดูลที่เปลี่ยนบ่อยหรือที่ธุรกิจต้องพึ่งพา
- ในฐานะผู้มีส่วนได้ส่วนเสีย: ให้ความสำคัญกับคุณภาพมากกว่าปริมาณ ตั้งกำหนดส่งให้สมจริง เข้าร่วม user acceptance testing และขอรายงานผลการทดสอบ
- ในฐานะผู้จัดการโปรเจกต์: เผื่อเวลาไว้ในแผน ตกลงกับทุกคนว่า "เสร็จ" หมายถึงอะไร และจัดประชุมรีวิวที่ทีมโชว์ซอฟต์แวร์ที่ใช้งานได้จริง
เคสจริง: ฟีเจอร์เดียวเสียนานกว่าหนึ่งปี
Waterleau บริษัทบำบัดน้ำจากเบลเยียม สร้าง Capacity Planning Tool สำหรับใช้ภายใน เพื่อให้ผู้จัดการโปรเจกต์และผู้บริหารระดับสูงเห็นภาพทรัพยากร งบประมาณ และความสามารถในการทำกำไรของแต่ละโปรเจกต์อย่างชัดเจน หนึ่งในฟีเจอร์สำคัญที่สุด คือฟังก์ชัน "freeze hours" ที่เชื่อมกับ SAP ทำงานผิดพลาดมานานกว่าหนึ่งปี และพาร์ตเนอร์พัฒนารายเดิมแก้ไม่ได้
ผลที่ตามมาตรงกับสิ่งที่บทความนี้เตือนไว้ทุกอย่าง ข้อมูลเชื่อถือไม่ได้อีกต่อไป ผู้วางแผนกลับไปใช้ไฟล์ Excel ของตัวเอง และเงินลงทุนก้อนใหญ่กำลังกลายเป็นเครื่องมือที่ไม่มีใครใช้
เราเข้าไปรับ codebase ที่เขียนโดยวิศวกรหลายคน ซึ่งใช้มาตรฐานต่างกันและแทบไม่มีเอกสาร แทนที่จะแก้แบบเร่งด่วนอีกรอบ เราเริ่มจากทำความเข้าใจว่าระบบทำงานจริงอย่างไร จากนั้นสร้างโมดูล freeze hours ขึ้นใหม่ refactor โค้ดที่เกี่ยวข้อง และเพิ่มการตรวจสอบข้อมูลที่แจ้งเตือนทันทีเมื่อข้อมูลใน SAP กับสิ่งที่เครื่องมือแสดงไม่ตรงกัน เราส่งมอบการแก้ไขทั้งหมดภายใน 8 สัปดาห์ตรงตามกำหนด และวันนี้เรายังทำงานกับ Waterleau ในเฟสถัดไปของแพลตฟอร์ม
บทเรียนคือ กับดักเกือบทุกข้อข้างบนปรากฏอยู่ในโปรเจกต์เดียว ความเป็นเจ้าของโค้ดไม่ชัด ไม่มีการทดสอบรอบระบบเชื่อมต่อที่สำคัญ และการแก้ไขที่รักษาอาการแทนที่จะแก้ต้นเหตุ อ่านเรื่องราวทั้งหมดได้ในกรณีศึกษา Waterleau

4. ละเลยการขยายระบบ
ผลิตภัณฑ์ออนไลน์แล้ว ยินดีด้วย จากนั้นจำนวนผู้ใช้ก็เพิ่มขึ้น บางเซอร์วิสยังรับไหว บางเซอร์วิสเริ่มติดขัด ผู้ใช้รู้สึกว่าช้า และรีวิวแง่ลบชุดแรกก็เริ่มเข้ามา ความสำเร็จกลายเป็นภาระ
การเตรียมรับความสำเร็จสำคัญพอ ๆ กับการลดความเสี่ยง ค่า cloud พุ่งขึ้นเมื่อคำตอบเดียวคือเพิ่มเซิร์ฟเวอร์ ความปลอดภัยยิ่งสำคัญเมื่อมีคนไว้ใจฝากข้อมูลกับคุณมากขึ้น และการเพิ่มฟีเจอร์ก็ยากขึ้นใน codebase ที่ทำแบบรีบ ๆ และไม่เป็นระเบียบ
วิธีหลีกเลี่ยง: คิดเรื่องการเติบโตตั้งแต่เริ่ม ทำตามแนวปฏิบัติที่ดีทั้งตอนเขียนโค้ด ตั้งค่าเซิร์ฟเวอร์ และจัดเก็บข้อมูล และเลือกสถาปัตยกรรมที่โตไปพร้อมผลิตภัณฑ์ได้ โดยไม่ทำเวอร์ชันแรกให้ซับซ้อนเกินจำเป็น
- ในฐานะผู้มีส่วนได้ส่วนเสีย: บอกเป้าหมายของคุณให้ชัด สถานการณ์ที่ดีที่สุดหน้าตาเป็นอย่างไร และฟีเจอร์ในฝันข้อไหนที่ยังไม่จำเป็นสำหรับเวอร์ชันแรก?
- ในฐานะผู้จัดการโปรเจกต์: ดูให้ทีมทำตาม coding guideline ทำ internal audit และให้ทีมโฟกัสกับเป้าหมายระยะยาว
เช็กลิสต์ก่อนเริ่มโปรเจกต์ถัดไป
- scope ถูกเขียนไว้ในหน้าเดียว และคนที่จะใช้ซอฟต์แวร์ยืนยันแล้วหรือยัง?
- ฝั่งลูกค้ามีคนเดียวที่เป็นผู้ตัดสินใจเรื่องผลิตภัณฑ์หรือไม่?
- ทีมมีประสบการณ์จริงกับ stack ที่เลือก หรือมี proof of concept แล้วหรือยัง?
- ใครเป็นเจ้าของโค้ด โฮสติ้ง และบัญชีต่าง ๆ ตั้งแต่วันแรก?
- มีแผนทดสอบในทุก sprint พร้อมนิยามที่ชัดเจนว่า "เสร็จ" คืออะไรหรือไม่?
- คุณรู้หรือไม่ว่าจะเกิดอะไรขึ้นเมื่อผู้ใช้เพิ่มขึ้น 10 เท่า?
- มีแผนและงบประมาณสำหรับการดูแลระบบหลังเปิดตัวหรือไม่?
สรุป
ทุกขั้นตอนในวงจรการพัฒนามีความสำคัญ การข้ามกระบวนการที่ดูเหมือนเล็กน้อยจะสร้างหนี้ทางเทคนิคที่แก้แพง หรือในกรณีแย่ที่สุดก็ทำให้โปรเจกต์ล่ม ที่ We Do Dev Work เราก็ทำพลาดเหมือนกัน ทุกทีมจัด sprint retrospective เพื่อเปิดปัญหาออกมาคุยและปรับปรุงวิธีทำงาน เราให้ลูกค้ามีส่วนร่วมและรับรู้ความคืบหน้าตลอด และให้ความสำคัญกับซอฟต์แวร์ที่ดูแลต่อได้และความสัมพันธ์ระยะยาวมากกว่ากำหนดส่งที่ตั้งขึ้นมาเอง
โปรเจกต์ของคุณหลุดจากเส้นทางไปแล้วหรือเปล่า? อ่านวิธีที่เรากู้โปรเจกต์ซอฟต์แวร์ หรือเล่าให้เราฟังว่าเกิดอะไรขึ้น การตรวจด้วย EngineeringScore ฟรี ช่วยให้เห็นสุขภาพของเว็บไซต์ที่ออนไลน์อยู่ได้อย่างรวดเร็ว
อ่านต่อ
คำถามที่พบบ่อย
ข้อผิดพลาดที่พบบ่อยที่สุดในการพัฒนาซอฟต์แวร์มีอะไรบ้าง?
มี 4 เรื่องที่เจอแทบทุกโปรเจกต์ที่มีปัญหา คือ รากฐานไม่ดี (requirement ไม่ชัด) เลือก tech stack ผิด เปิดตัวโดยไม่ได้ทดสอบให้ดี และไม่คิดเรื่องการขยายระบบ
จะหลีกเลี่ยง scope creep และงานแก้ซ้ำได้อย่างไร?
เริ่มด้วยช่วง discovery: ศึกษาปัญหา เขียน scope ให้จบในหน้าเดียว ตรวจดีไซน์กับคนที่จะใช้ซอฟต์แวร์จริง และมี backlog ที่จัดลำดับความสำคัญไว้ ทุกคำขอใหม่จะกลายเป็นการตัดสินใจอย่างรู้ตัว แทนที่จะเป็นงานเพิ่มที่แอบงอกขึ้นมา
จะเลือก tech stack ที่เหมาะสมได้อย่างไร?
ดูเรื่อง vendor lock-in ระยะเวลาที่ทีมต้องใช้เรียนรู้ ความปลอดภัย การสนับสนุนจากคอมมูนิตี้ และการดูแลรักษาในระยะยาว จากนั้นทำ proof of concept เล็ก ๆ ก่อนตัดสินใจเดินแผนพัฒนายาว
ทำไมการทดสอบก่อนเปิดตัวจึงสำคัญมาก?
บั๊กที่เจอหลังเปิดตัวจะกลายเป็นเรื่องด่วนและแก้แพงกว่า ส่วนฟีเจอร์ที่แสดงข้อมูลผิดแบบเงียบ ๆ จะทำลายความเชื่อมั่นในทั้งระบบ ควรทดสอบในหลายสภาพแวดล้อม ทำ user acceptance testing และให้ QA เป็นส่วนหนึ่งของทุก sprint
ถ้าโปรเจกต์พังไปแล้วควรทำอย่างไร?
หยุดเพิ่มฟีเจอร์ ให้ทีมอิสระเข้ามาดูว่าระบบทำงานจริงอย่างไร แล้วแก้ที่ต้นเหตุแทนการปะอาการ ที่ Waterleau เราสร้างโมดูลที่เชื่อมกับ SAP ซึ่งเสียอยู่ขึ้นใหม่ และส่งมอบการแก้ไขทั้งหมดภายใน 8 สัปดาห์
บทความที่เกี่ยวข้อง
Supabase vs Firebase (2026): เลือกอย่างไหนสำหรับแอปของคุณ
Supabase หรือ Firebase ในปี 2569? เปรียบเทียบจากทีมที่ใช้ Supabase กับสามผลิตภัณฑ์ ทั้งโมเดลข้อมูล ความปลอดภัย ราคา ณ 19 พ.ย. 2569 และวิธีเลือก

ทดสอบ Claude Fable 5.2 กับบั๊กจริง 2 ตัว: คุ้มค่าไหม?
Claude Fable 5.2 เปิดตัว 9 พฤศจิกายน 2569 เราให้มันและ Opus 5.5 แก้บั๊กจริง 2 ตัวจากเว็บไซต์ของเราเอง ทั้งคู่หาสาเหตุเจอ แต่ Opus ใช้ต้นทุนไม่ถึงครึ่ง
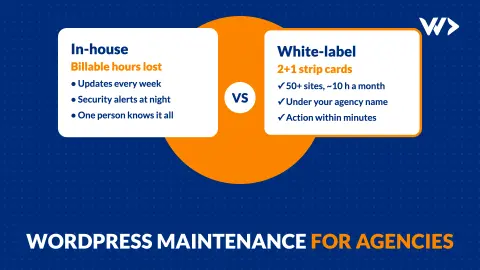
บริการดูแลและบำรุงรักษาเว็บไซต์ WordPress สำหรับเอเจนซี: White-label รองรับเว็บไซต์มากกว่า 50 แห่ง
เอเจนซีด้านการออกแบบจะให้บริการดูแลและบำรุงรักษาเว็บไซต์ WordPress ของลูกค้ามากกว่า 50 แห่งได้อย่างไร โดยไม่ต้องมี Developer ประจำทีม: ครอบคลุมทั้งขั้นตอนการทำงาน ค่าใช้จ่าย และสิ่งที่เกิดขึ้นในวันอัปเดตแพตช์ความปลอดภัย