Les bases de l'IA pour l'entreprise : LLM, RAG, agents et fine-tuning expliqués

Chez We Do Dev Work, nous n'utilisons pas seulement l'IA (pour rédiger des articles de blog), nous construisons avec elle chaque jour. Mais le vocabulaire est saturé de mots à la mode, et il est difficile de savoir lesquels comptent vraiment pour une entreprise. Ce guide s'adresse aux fondateurs, aux product managers, aux développeurs et aux curieux qui veulent comprendre les vraies briques des systèmes d'IA modernes, et savoir par laquelle commencer.
Si vous voulez la version en un paragraphe : la plupart des projets d'IA en entreprise consistent aujourd'hui à prendre un modèle de langage existant et à lui donner vos informations (RAG) et, parfois, la capacité d'agir (agents). Réentraîner un modèle (fine-tuning) est l'exception, pas le point de départ.
Les termes clés en un coup d'œil
| Terme | Sens courant | Utile pour | Points d'attention |
|---|---|---|---|
| Machine learning | Des logiciels qui apprennent des motifs à partir de données au lieu de suivre des règles écrites à la main. | Prédiction et classification : prévoir la demande, repérer la fraude, trier des tickets. | Demande des données de qualité et pertinentes. Le résultat est une probabilité, pas une garantie. |
| LLM (grand modèle de langage) | Un modèle de machine learning entraîné sur d'énormes quantités de texte, capable de lire et d'écrire le langage. | Rédiger, résumer, répondre à des questions, extraire des données de textes désordonnés. | Il peut affirmer des choses fausses avec aplomb, et il ne connaît que ce sur quoi il a été entraîné plus ce que vous lui donnez. |
| Prompt engineering | Rédiger des instructions et des exemples clairs pour que le modèle produise un résultat utile. | La première étape la moins chère. Souvent suffisante pour des tâches simples. | Les résultats peuvent varier ; testez les prompts sur des exemples réels, pas sur un seul essai chanceux. |
| Embeddings et bases de données vectorielles | Du texte converti en nombres qui capturent le sens, stockés de façon à pouvoir chercher par le sens plutôt que par les mots exacts. | Recherche dans vos propres documents, repérage d'éléments similaires, recommandations. | La qualité de la recherche dépend de la manière dont les documents sont découpés et tenus à jour. |
| RAG (génération augmentée par récupération) | Chercher d'abord des passages pertinents dans vos documents, puis les donner au LLM pour qu'il réponde à partir d'eux. | Bots de support, recherche dans la connaissance interne, réponses qui doivent respecter vos règles. | Si le bon document n'est pas trouvé, la réponse sera mauvaise. Demande des contenus sources bien rangés. |
| Agents IA | Des systèmes où un LLM décide des étapes et utilise des outils (recherche, agenda, base de données, e-mail) pour atteindre un objectif. | Travail en plusieurs étapes : trier des demandes, préparer des rapports, mettre à jour des fiches. | Plus de pièces mobiles, donc plus de façons d'échouer. Gardez un humain qui valide tout ce qui est risqué. |
| Fine-tuning | Poursuivre l'entraînement d'un modèle de base sur vos propres exemples pour changer son comportement. | Un ton ou un format de sortie constant, ou une tâche ciblée réalisée à grande échelle. | Demande des données d'entraînement de qualité et de l'effort, et le résultat reste figé tant que vous ne réentraînez pas. |
| IA multimodale | Des modèles qui traitent les images, l'audio ou la vidéo en plus du texte. | Lire des factures et des captures d'écran, transcrire des appels, décrire des photos de produits. | Vérifiez la précision sur vos propres fichiers, pas sur des démos. |
Le machine learning, le grand parapluie
Le machine learning est le vaste domaine d'ensemble. Un modèle apprend à partir d'exemples, puis applique ce qu'il a appris à de nouvelles données. Les filtres anti-spam, les prévisions de demande et les listes de recommandations relèvent tous du machine learning, et ils existaient bien avant les chatbots. Quand quelqu'un dit « IA » en réunion, demandez s'il parle de cette forme plus ancienne (prédire un nombre ou une étiquette à partir de vos données) ou de la forme plus récente des modèles de langage (produire du texte). Ils résolvent des problèmes différents et demandent des données différentes.
Les grands modèles de langage (LLM)
Les LLM sont les moteurs derrière des outils comme ChatGPT, Claude et Gemini, et derrière des modèles ouverts comme Llama, Mistral et DeepSeek. Ils sont entraînés sur d'énormes quantités de texte pour générer un langage proche de celui des humains.
Exemple d'usage : aide à la rédaction, résumé de rapports, réponses aux questions des clients.
Voyez les LLM comme le cerveau généraliste capable de répondre et de générer du texte à partir des motifs qu'il a appris.
Ce que cela signifie pour une entreprise : un LLM excelle dans le travail sur le langage et n'est pas fiable comme source de vérité. Il ne connaît ni vos prix, ni vos contrats, ni les décisions de la semaine dernière, sauf si vous les lui donnez. C'est cet écart que traitent les sections suivantes.
Prompt engineering
Le prompt engineering consiste à soigner les entrées pour obtenir de meilleures sorties d'un LLM. Il peut modifier fortement les résultats, et il ne coûte presque rien à essayer.
Exemple d'usage : réécrire un prompt vague comme « Écris sur le marketing » en « Écris un résumé en 3 paragraphes des tendances actuelles du marketing B2B, dans un langage persuasif. »
D'excellents prompts = d'excellents résultats. De bons prompts = des résultats incertains.
Embeddings et bases de données vectorielles
Un embedding convertit du texte en vecteur (une liste de nombres) qui représente son sens. Cela permet aux ordinateurs de comparer le sens, et pas seulement les mots exacts. Une fois les embeddings en main, il faut un endroit pour les stocker et les interroger. C'est là qu'interviennent les bases vectorielles comme Pinecone, Weaviate ou pgvector (utilisé dans notre cher Supabase).
Exemple d'usage : chercher dans une base de connaissances des documents similaires même si les mots employés sont différents, pour que votre chatbot trouve le bon document interne.
Les embeddings et les bases vectorielles rendent les applications d'IA « conscientes » de vos données propres.
Génération augmentée par récupération (RAG)
Le RAG est une technique qui récupère des documents pertinents grâce aux embeddings et les transmet au LLM avant qu'il ne génère une réponse. Le modèle répond à partir de vos contenus plutôt que de sa mémoire, et vous pouvez montrer de quel document provient une réponse.
Exemple d'usage : un chatbot de support client qui va chercher les règles dans le manuel de votre entreprise avant de répondre.
Le RAG est généralement plus flexible et moins cher que le fine-tuning, parce que mettre à jour la réponse revient à mettre à jour un document, pas à réentraîner un modèle.
Agents IA
Les agents sont des systèmes qui utilisent des LLM pour agir. Contrairement à un chatbot passif, un agent peut raisonner sur un objectif, garder le contexte en mémoire, appeler des outils et enchaîner plusieurs étapes.
Exemple d'usage : un assistant virtuel qui organise votre semaine en lisant votre agenda, en réservant vos voyages et en envoyant des rappels.
Un agent, ce n'est pas seulement du chat ; il peut faire des choses à partir de la sortie du LLM.
Plus un agent peut faire de choses, plus il faut être prudent. Donnez-lui les permissions les plus étroites qui fonctionnent, journalisez ce qu'il fait, et placez une personne dans la boucle pour tout ce qui dépense de l'argent, supprime des données ou contacte des clients.
Fine-tuning
Le fine-tuning prend un LLM de base et l'entraîne davantage sur vos propres exemples. Il crée une nouvelle version du modèle propre à votre usage, par exemple une qui écrit toujours dans votre ton de voix.
Exemple d'usage : un modèle entraîné sur vos anciennes réponses de support pour qu'il réponde dans le style et le format de votre maison.
Le fine-tuning est puissant, mais gourmand en ressources et statique.
Une erreur fréquente est de faire du fine-tuning pour enseigner des faits à un modèle. Les faits changent, et un modèle affiné ne les connaîtra pas tant que vous ne le réentraînez pas. Utilisez le RAG pour la connaissance et gardez le fine-tuning pour le comportement et le style.
IA multimodale
Certains systèmes d'IA ne traitent pas que le texte, mais aussi les images, l'audio et la vidéo : de la parole au texte, du texte à l'image, la lecture d'une capture d'écran ou d'une facture scannée.
Exemple d'usage : une IA qui analyse des captures d'écran, transcrit de l'audio ou extrait les lignes d'un ticket de caisse photographié.
Modèles ouverts ou fermés
Les modèles à poids ouverts (comme Llama, Mistral et DeepSeek) peuvent être téléchargés, hébergés par vous et adaptés. Les modèles fermés (comme ceux d'OpenAI, Anthropic et Google) s'utilisent via une API et ne peuvent pas être modifiés, même si beaucoup peuvent être personnalisés par des prompts et, dans certains cas, par un fine-tuning proposé par le fournisseur.
Exemple d'usage : héberger votre propre modèle quand les données doivent rester sur vos serveurs, ou appeler une API quand vous voulez le modèle le plus performant avec le moins de mise en place.
Ouvert = contrôle et flexibilité, mais c'est vous qui l'exploitez. Fermé = confort et capacité, mais vous dépendez d'un fournisseur.
Notez que « moins cher » n'est pas automatique avec les modèles ouverts : vous payez les serveurs et les personnes qui les exploitent. Nous détaillons les vrais coûts d'exploitation dans Le coût n'est pas nul.
De quoi avez-vous besoin ? Quelques règles empiriques
- Des réponses issues de vos documents : commencez par le RAG.
- Prédire ou classer à partir de vos propres chiffres (attrition, demande, fraude) : du machine learning classique, pas un LLM.
- Rédiger, résumer, extraire à partir de texte : un LLM avec un bon prompt, sans technologie en plus.
- Un travail qui traverse plusieurs systèmes et étapes : un agent, avec validation humaine des étapes risquées.
- Une voix ou un format constant, ou une tâche ciblée à fort volume : envisagez le fine-tuning, une fois que les prompts et le RAG ne suffisent plus.
- Des données sensibles qui ne peuvent pas quitter votre infrastructure : regardez des modèles ouverts que vous hébergez, ou des conditions de fournisseur adaptées à vos exigences de conformité.
Comment démarrer
- Choisissez un problème concret. Quelque chose de répétitif, riche en texte et pénible, comme répondre aux mêmes questions de support ou résumer de longs documents. Évitez le « mettre de l'IA partout ».
- Vérifiez vos données. Les documents sont-ils à jour, faciles à trouver et autorisés à l'usage ? Des sources désordonnées produisent des réponses désordonnées.
- Faites un prototype avec un modèle existant et des prompts. Essayez des exemples réels tirés de votre travail, y compris les cas délicats.
- Ajoutez le RAG si le modèle a besoin de vos connaissances, puis un agent seulement s'il doit agir. Faites le fine-tuning en dernier.
- Mesurez par rapport à une référence. Comparez la qualité et le temps gagné avec la façon dont le travail se fait aujourd'hui, et gardez d'abord une personne qui relit les résultats.
- Prévoyez les coûts d'exploitation et les risques : frais d'usage, suivi, et ce qui se passe quand le modèle se trompe. Voir Le coût n'est pas nul.
Pour une vue d'ensemble, lisez Qu'est-ce que le développement d'IA ? et comment l'IA a changé le développement logiciel. Si vous voulez de l'aide pour cadrer un premier projet, consultez notre service de développement d'IA ou nos tarifs.
Pour conclure
Comprendre ces concepts vous aide à voir l'IA non pas comme de la magie, mais comme une boîte à outils. Une boîte à outils qui peut vous aider à concevoir de meilleures solutions pour votre entreprise ou vos clients. L'avenir appartient à ceux qui savent assembler les pièces, en commençant petit et en mesurant honnêtement.
Envie de construire avec ces technologies ? Parlons-en. Chez We Do Dev Work, nous aidons les entreprises à transformer les outils d'IA en solutions pratiques et évolutives.
Toutes les tâches d'IA n'exigent pas un grand modèle de langage. Pour des décisions rapides et structurées comme le routage ou le scoring, lisez LLM vs modèles de type System One.
Questions fréquentes
Quelle est la différence entre le machine learning et un LLM ?
Le machine learning est le vaste domaine des logiciels qui apprennent à partir de données. Un LLM est un type de modèle de machine learning, entraîné sur du texte pour lire et écrire le langage.
Qu'est-ce que le RAG, en termes simples ?
Le RAG commence par chercher des passages pertinents dans vos propres documents et les donne au LLM, qui répond ainsi à partir de vos contenus plutôt que de sa mémoire.
Faut-il choisir le RAG ou le fine-tuning ?
Utilisez le RAG lorsque le modèle a besoin de vos connaissances, car mettre à jour un document est plus simple que réentraîner. Envisagez le fine-tuning uniquement pour un style ou un format constant, ou une tâche ciblée.
Qu'est-ce qu'un agent IA et en quoi diffère-t-il d'un chatbot ?
Un chatbot répond par du texte. Un agent utilise un LLM pour planifier des étapes et appeler des outils, comme un agenda ou une base de données, afin d'accomplir une tâche.
Ai-je besoin de mon propre modèle pour utiliser l'IA dans mon entreprise ?
En général non. La plupart des usages en entreprise commencent par un modèle existant via une API, enrichi de vos données grâce au RAG. Héberger un modèle ouvert compte surtout pour un contrôle strict des données.
Comment démarrer avec l'IA dans mon entreprise ?
Choisissez un problème répétitif et riche en texte, vérifiez vos données, faites un prototype avec un modèle existant et mesurez le résultat par rapport à la façon dont le travail se fait aujourd'hui.
Articles similaires
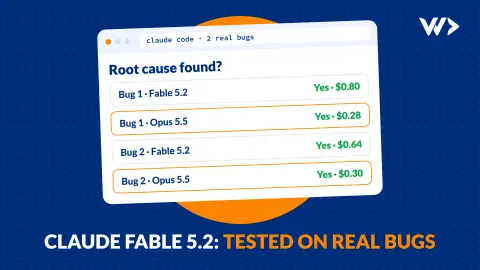
Claude Fable 5.2 testé sur 2 vrais bugs : vaut-il le prix ?
Claude Fable 5.2 est sorti le 9 nov. 2026. Nous l'avons testé avec Opus 5.5 sur deux vrais bugs de notre site : même cause trouvée, Opus pour moitié moins cher.

Connecter votre logiciel à Claude ou ChatGPT : ce qu'il faut pour un serveur MCP
Un serveur MCP permet à Claude ou ChatGPT de lire et modifier votre logiciel. Nous en avons bâti un en un jour : 1 338 modifications en 10 jours.
LLM vs modèle System One : Claude et ChatGPT face à Jev et SubQ Snap
Les LLM comme Claude et ChatGPT rédigent des réponses ; les modèles de décision System One comme Jev et SubQ Snap les choisissent. La différence, les prix et quand utiliser lequel.